Explorer la médiation scientifique
- CompaSciences est un moteur de recherche qui permet d’explorer les interventions d’universitaires sur la RTS.
- Il aide à identifier rapidement des expert·e·s et à parcourir les archives de la RTS de manière inédite.
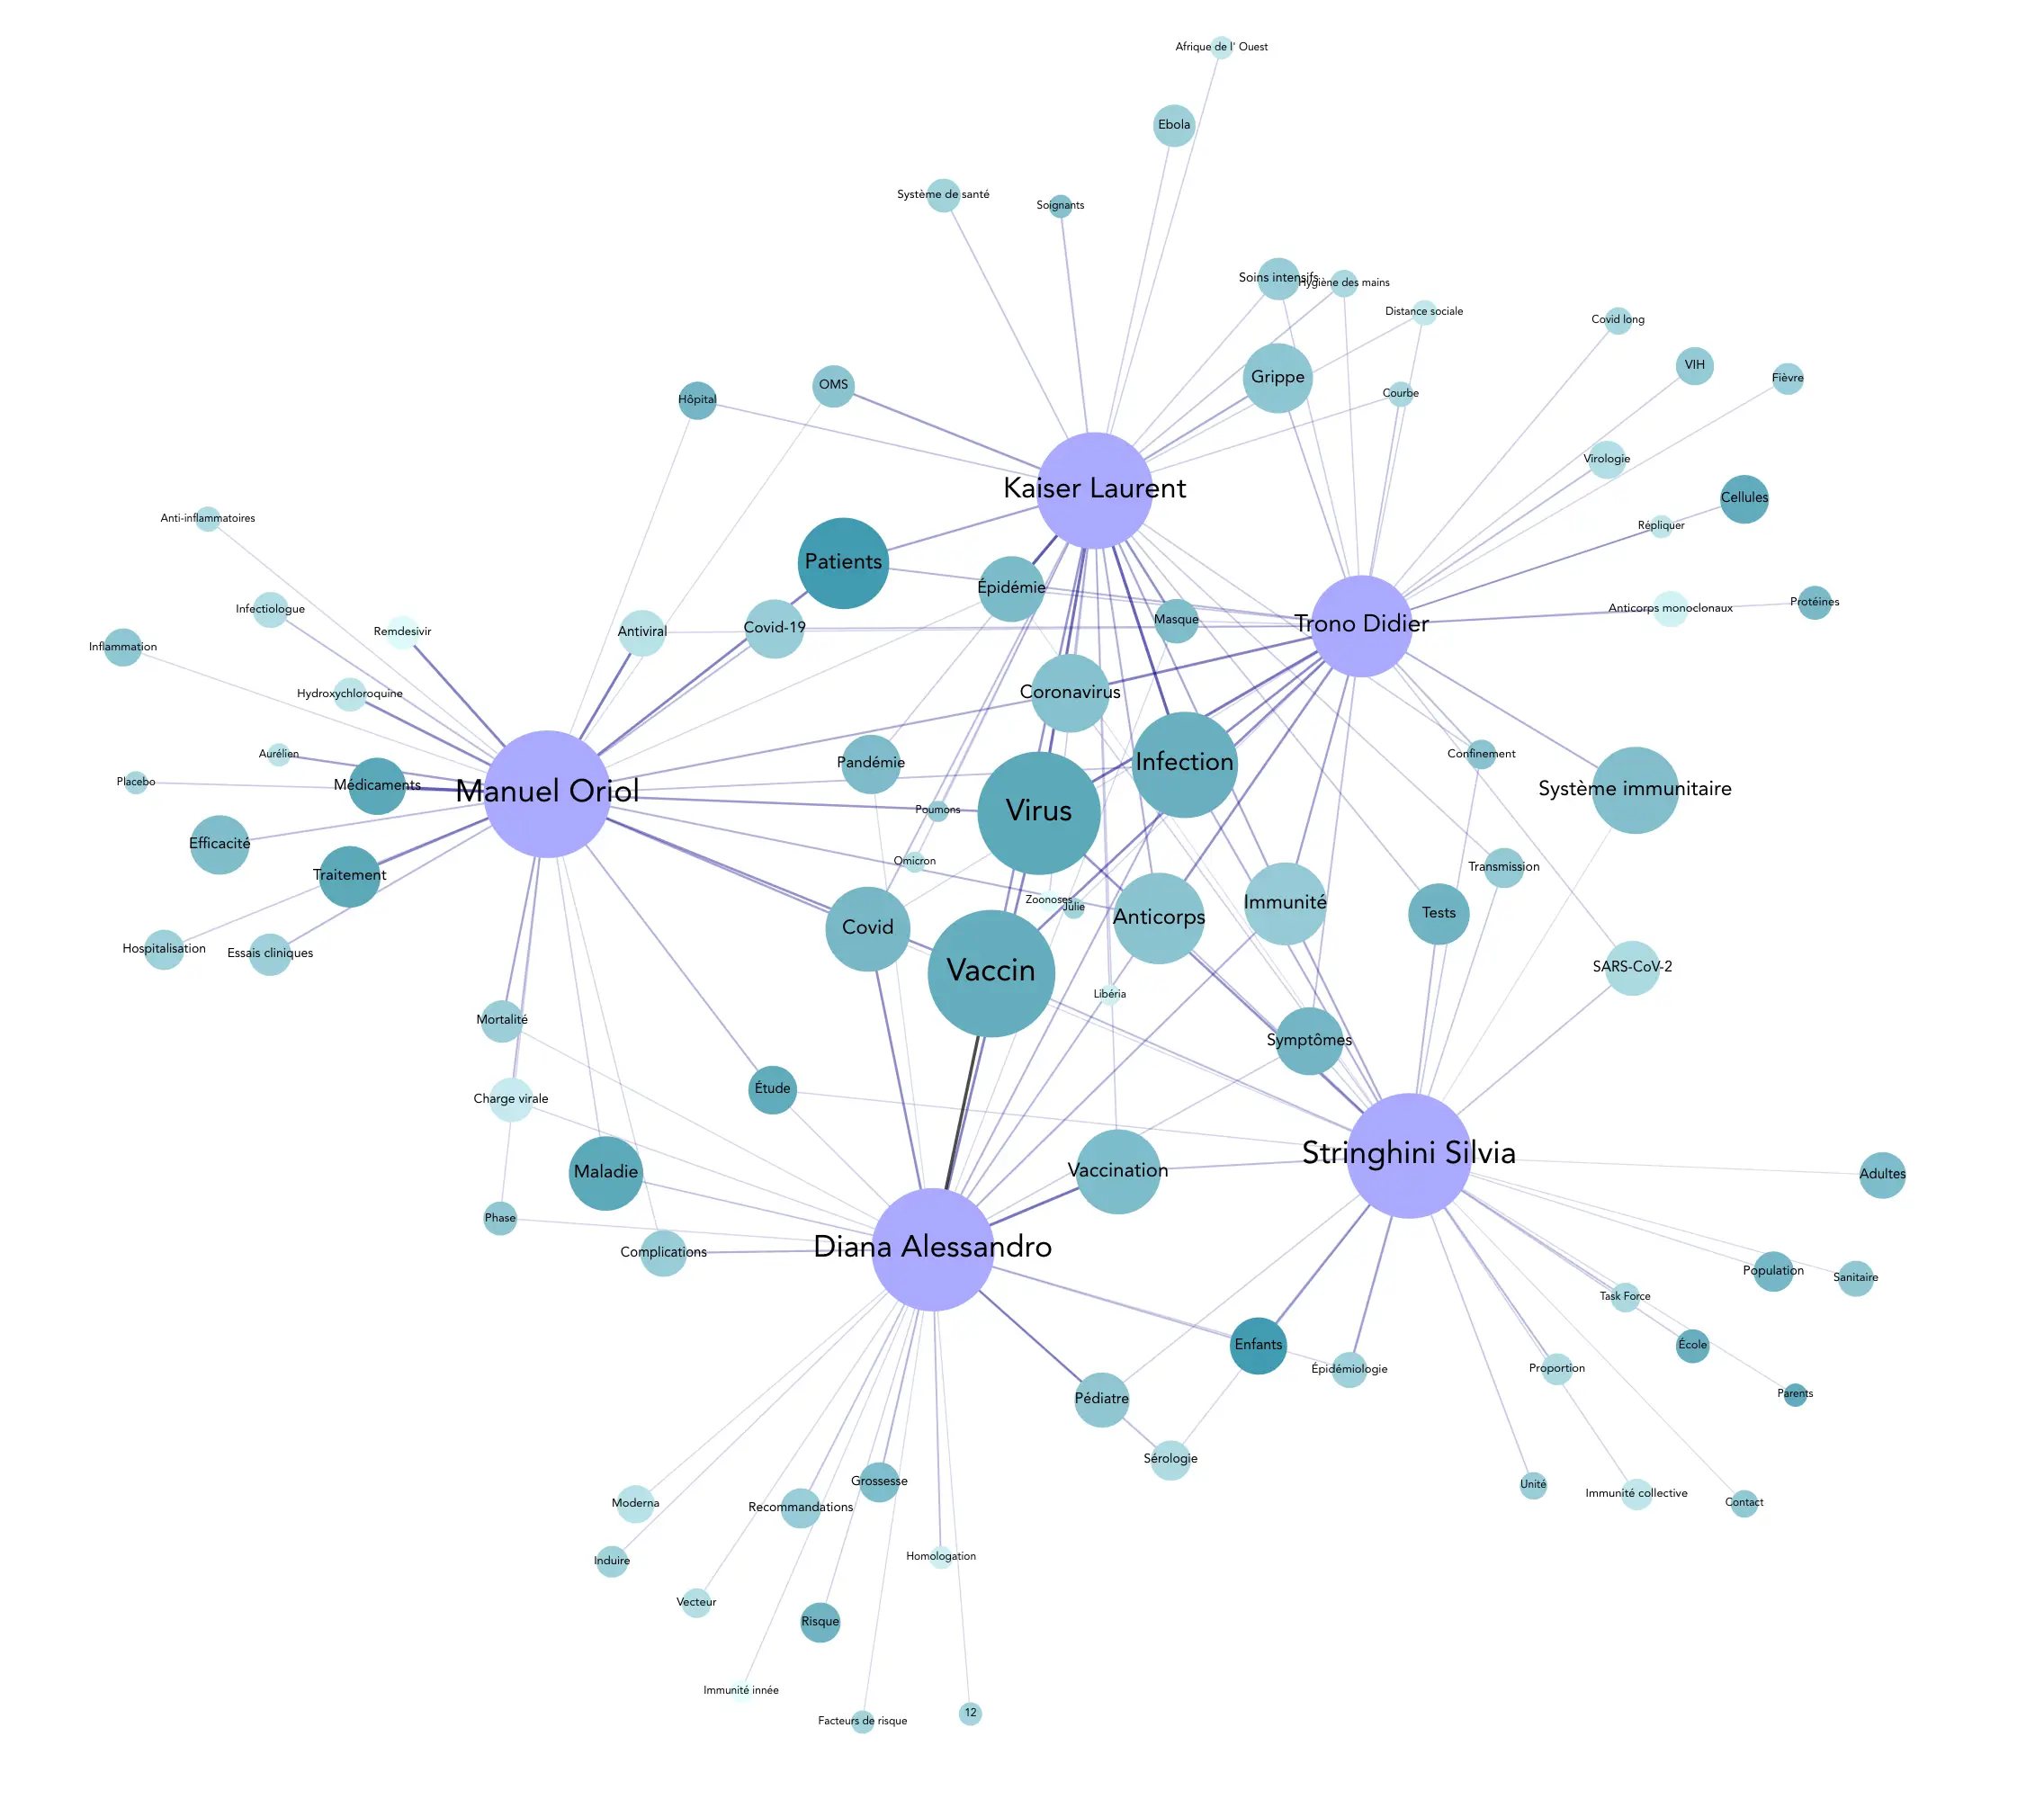
- À partir d’un corpus et de métadonnées, CompaSciences permet d’explorer dynamiquement les relations entre ce qui est exprimé (vocabulaire, notions…) et le contexte de cette expression (auteur, discipline, émission, genre…).
- Ce projet a été financé par l’Initiative for Media Innovation (IMI), en partenariat avec Avis d’experts (AdE) et les archives de la RTS.
Recherche

La barre de recherche interroge le corpus par terme, émission, expert·e, institution, genre et domaine.
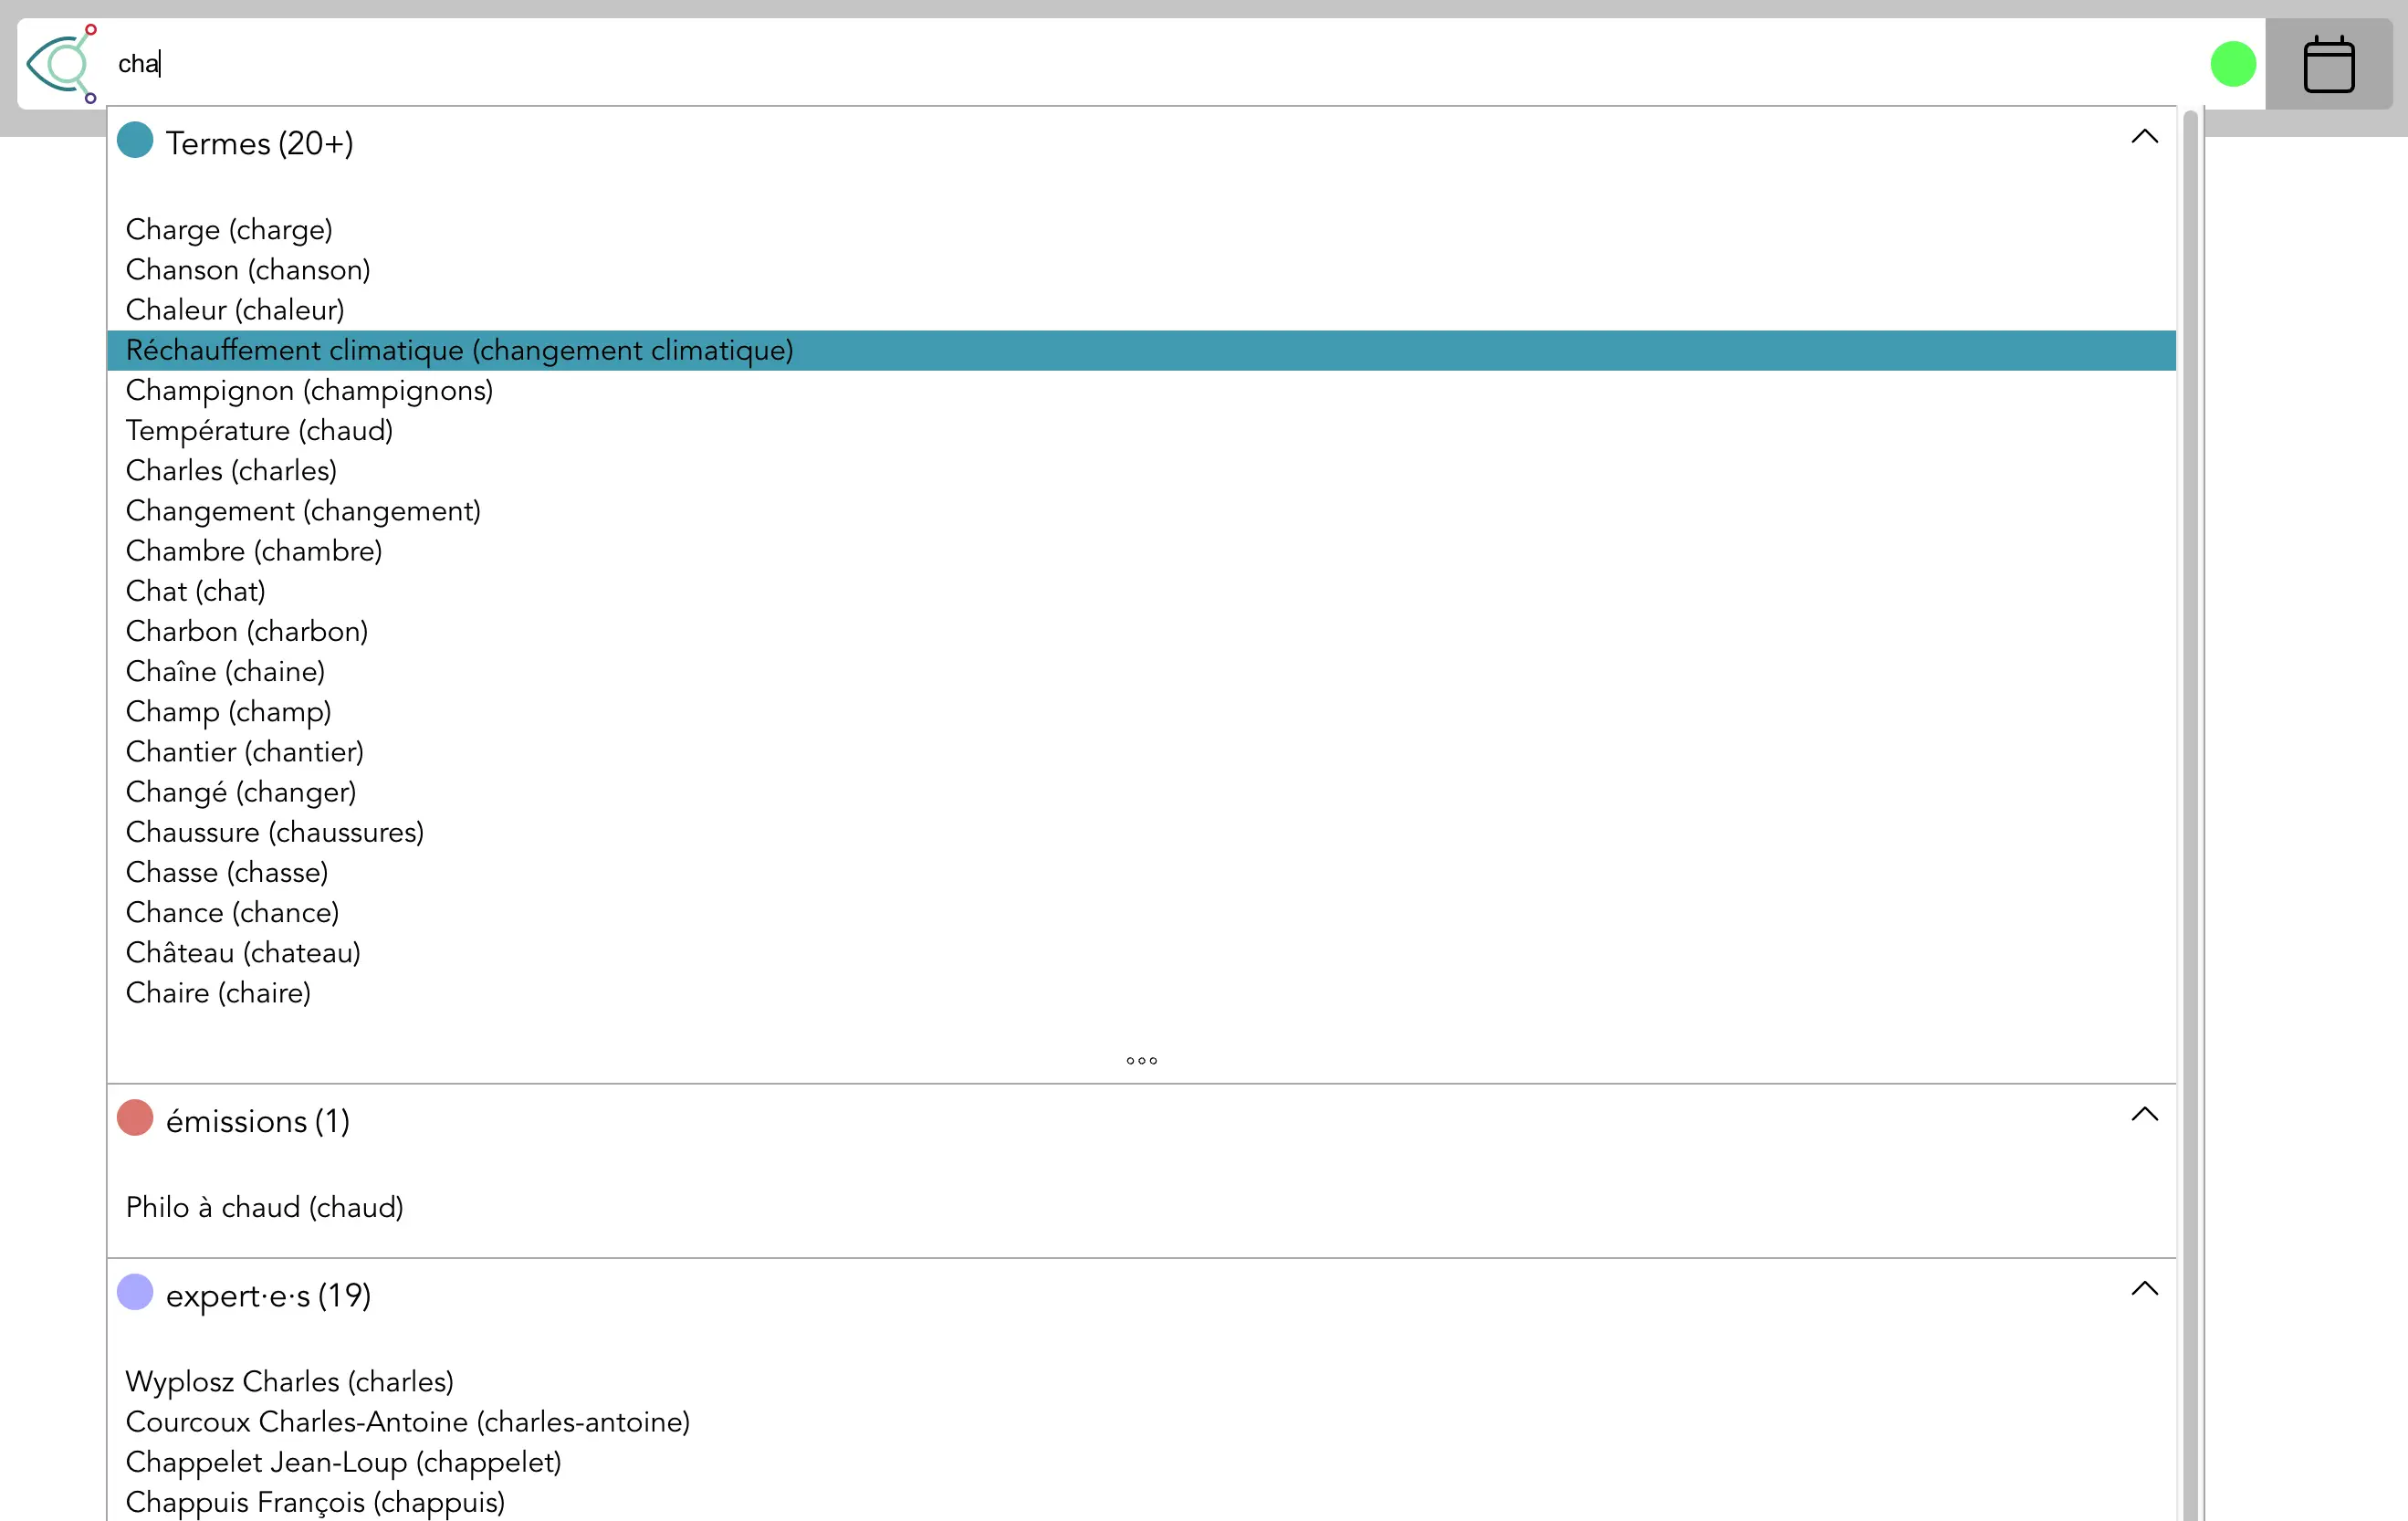
Exemples de recherche
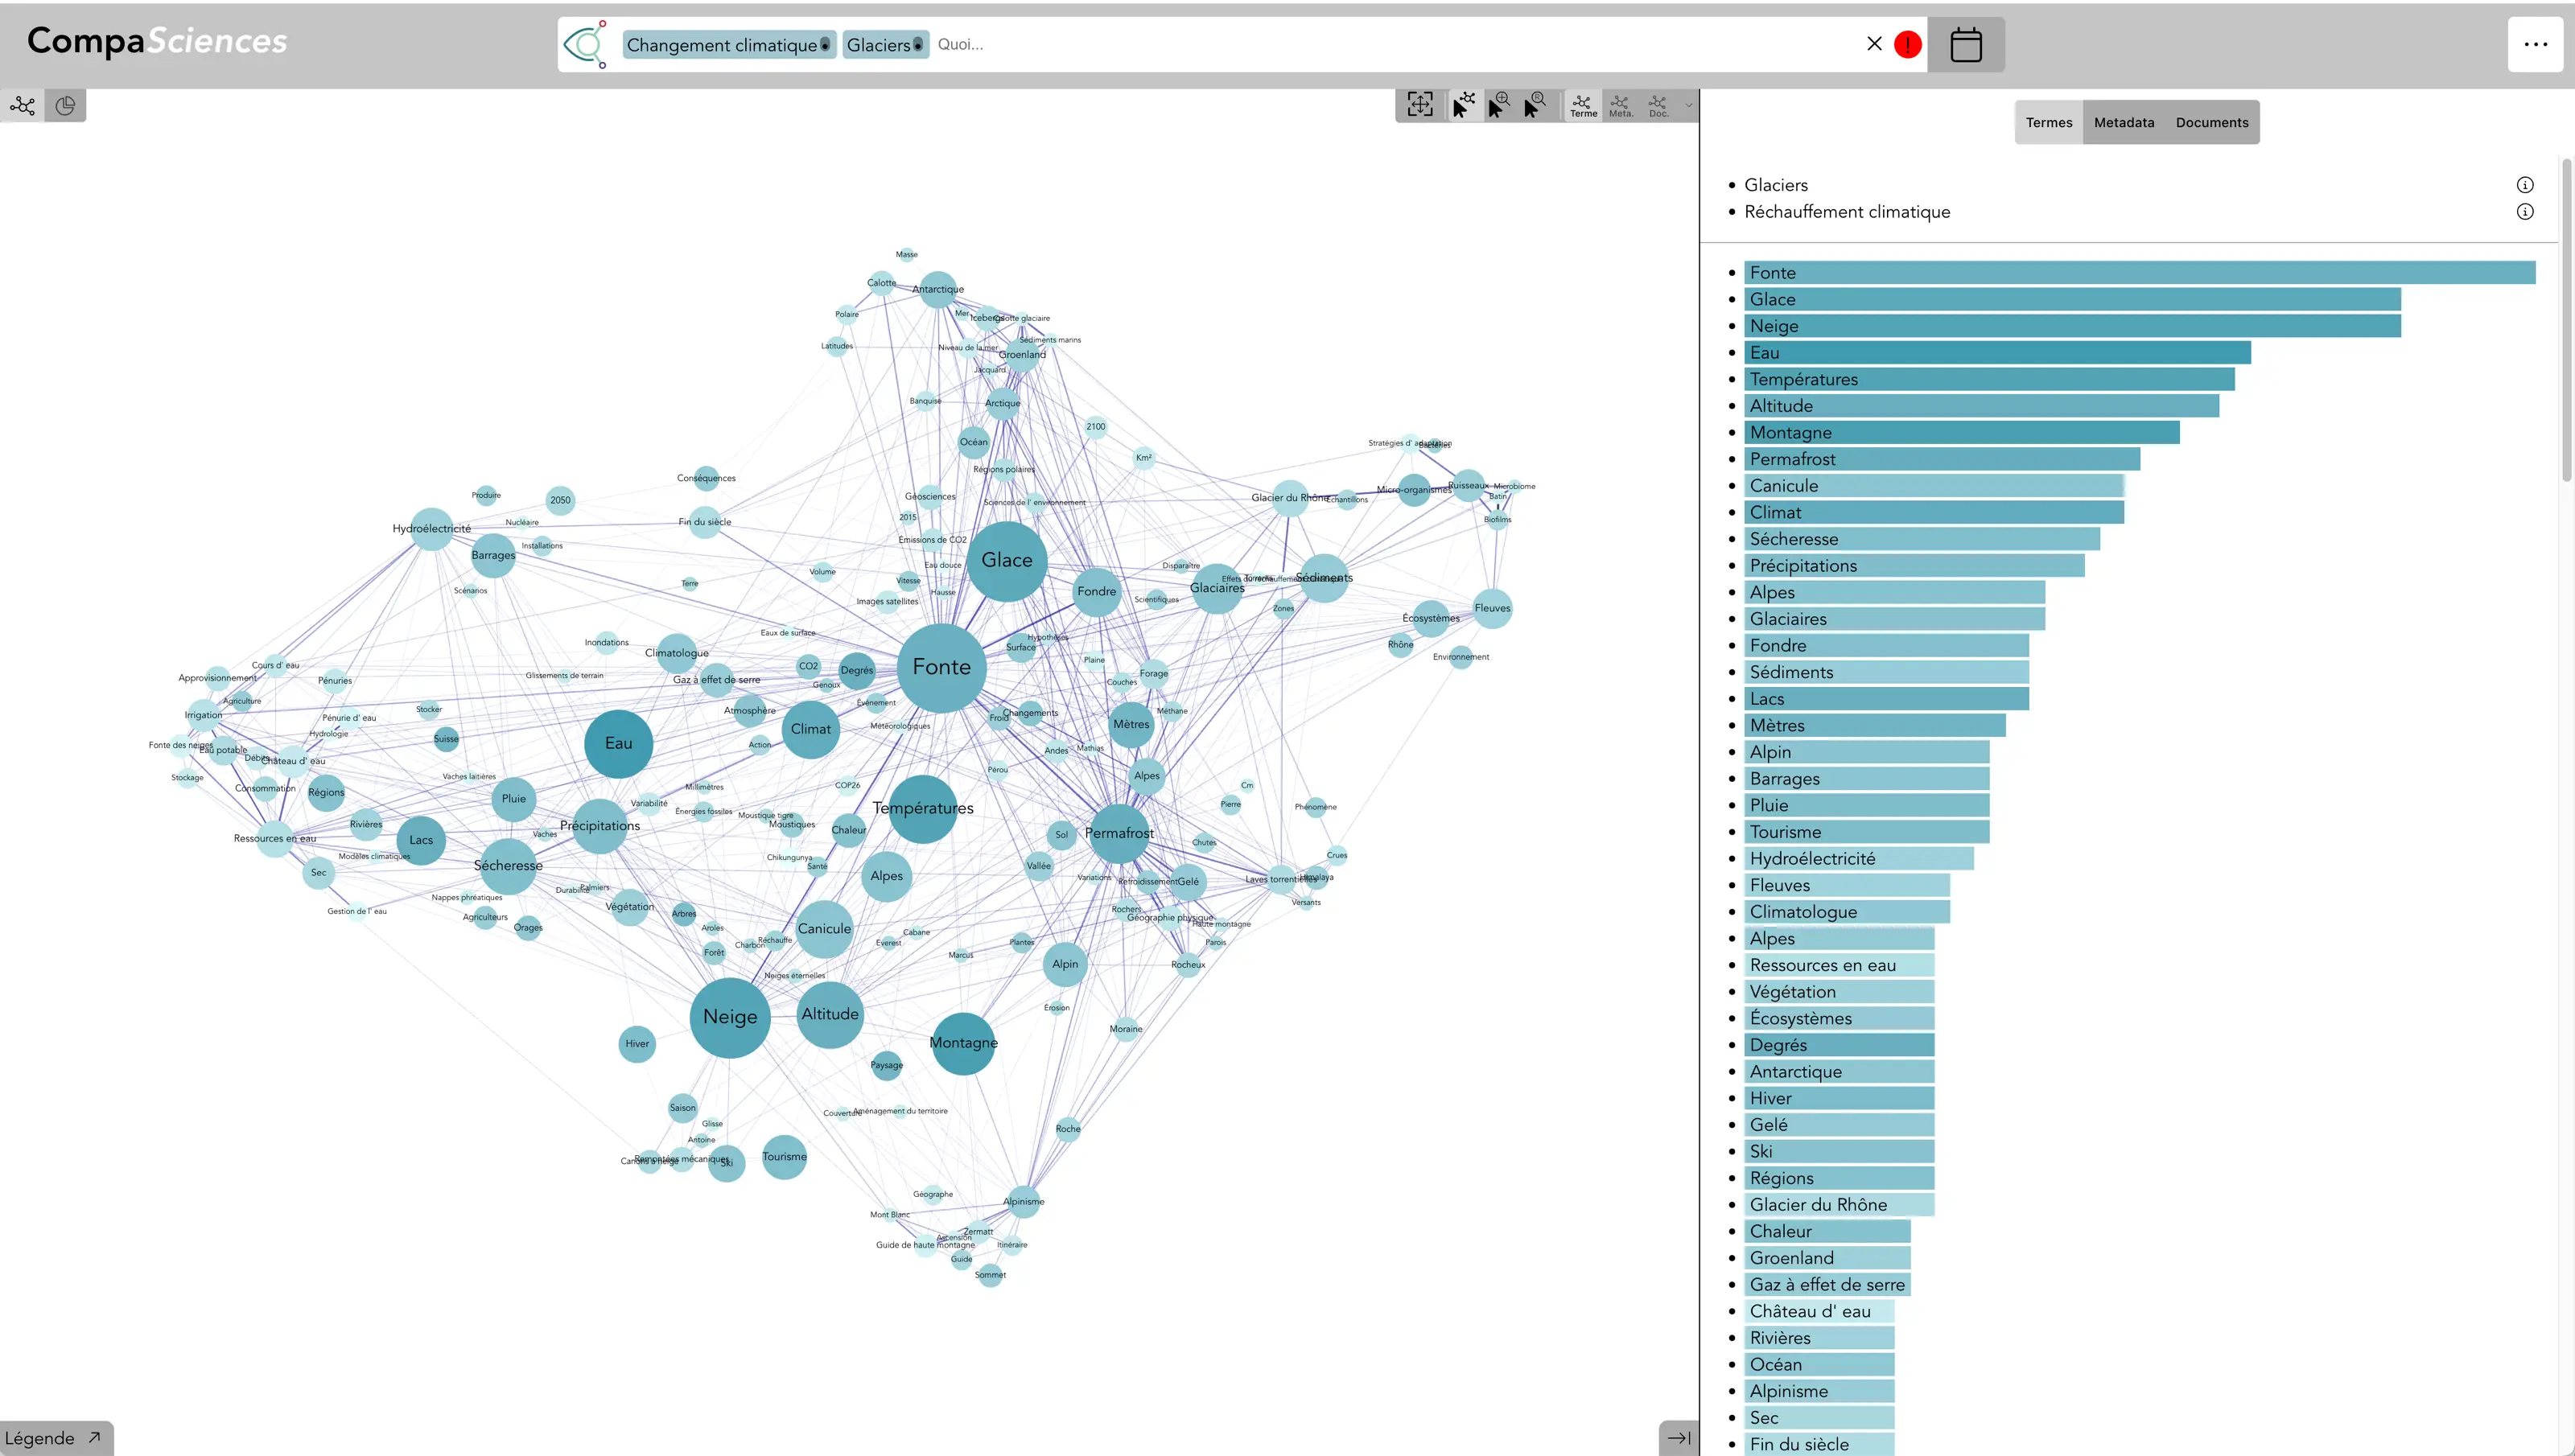
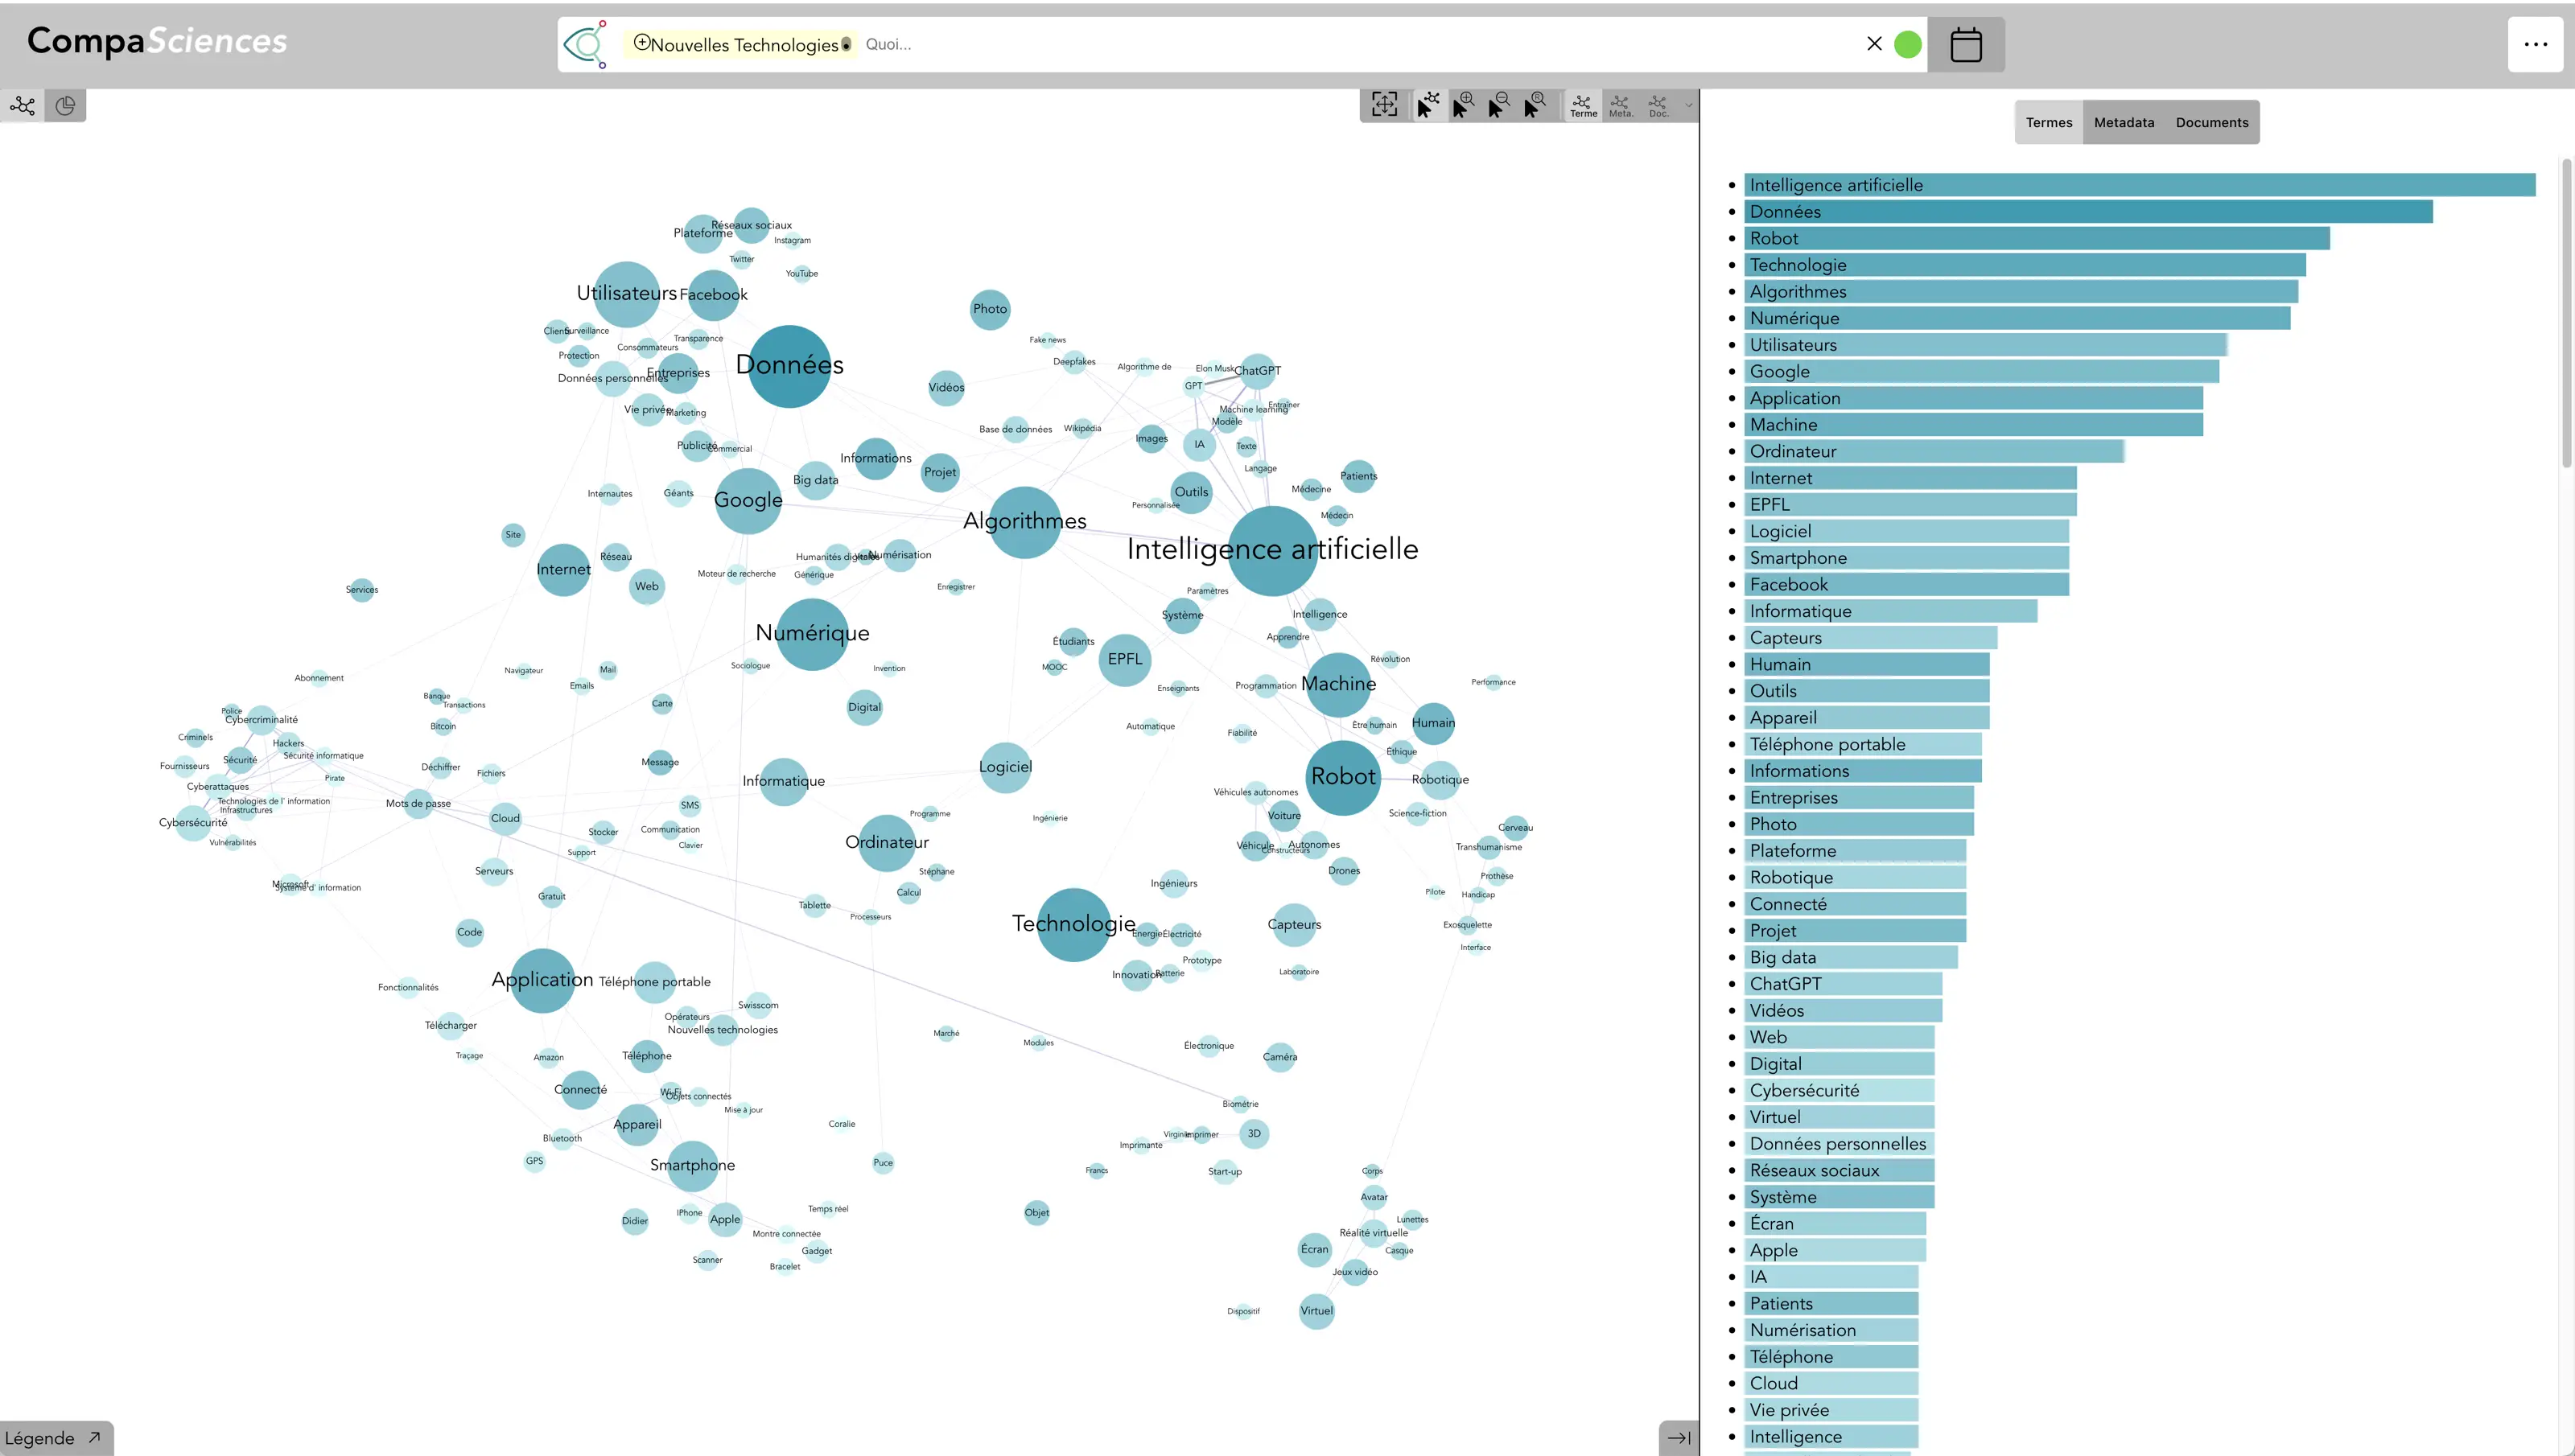
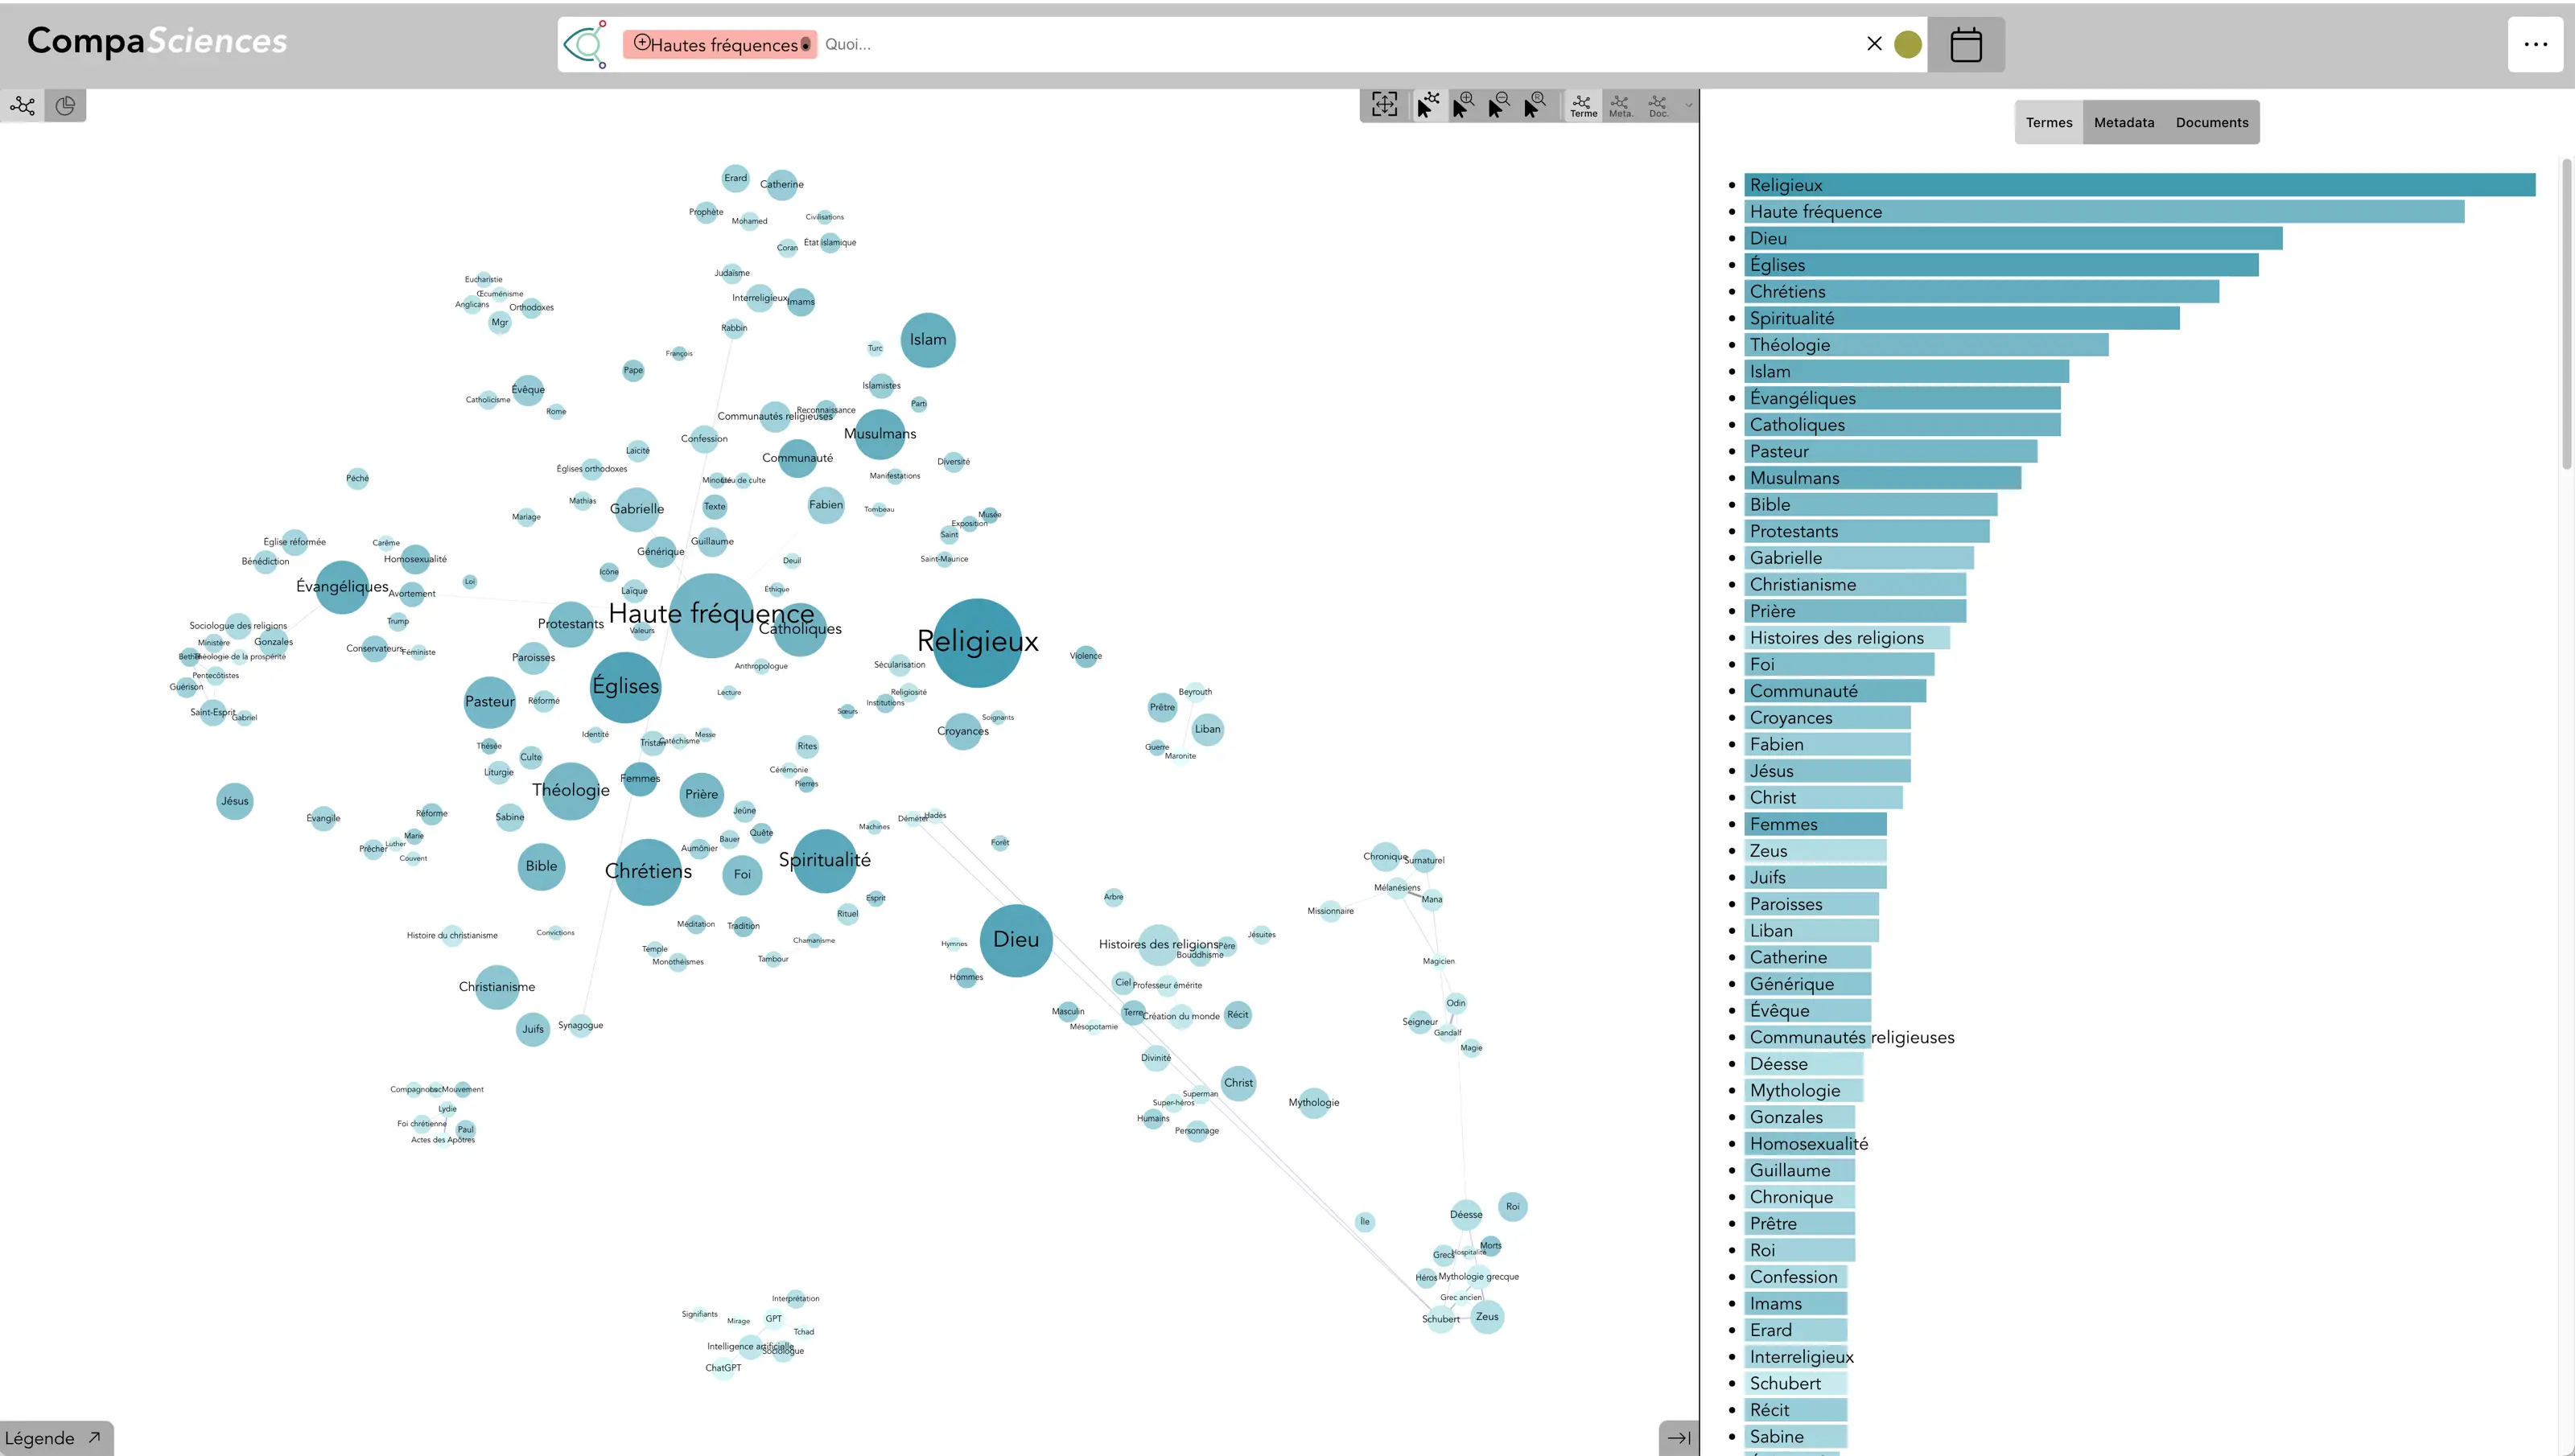
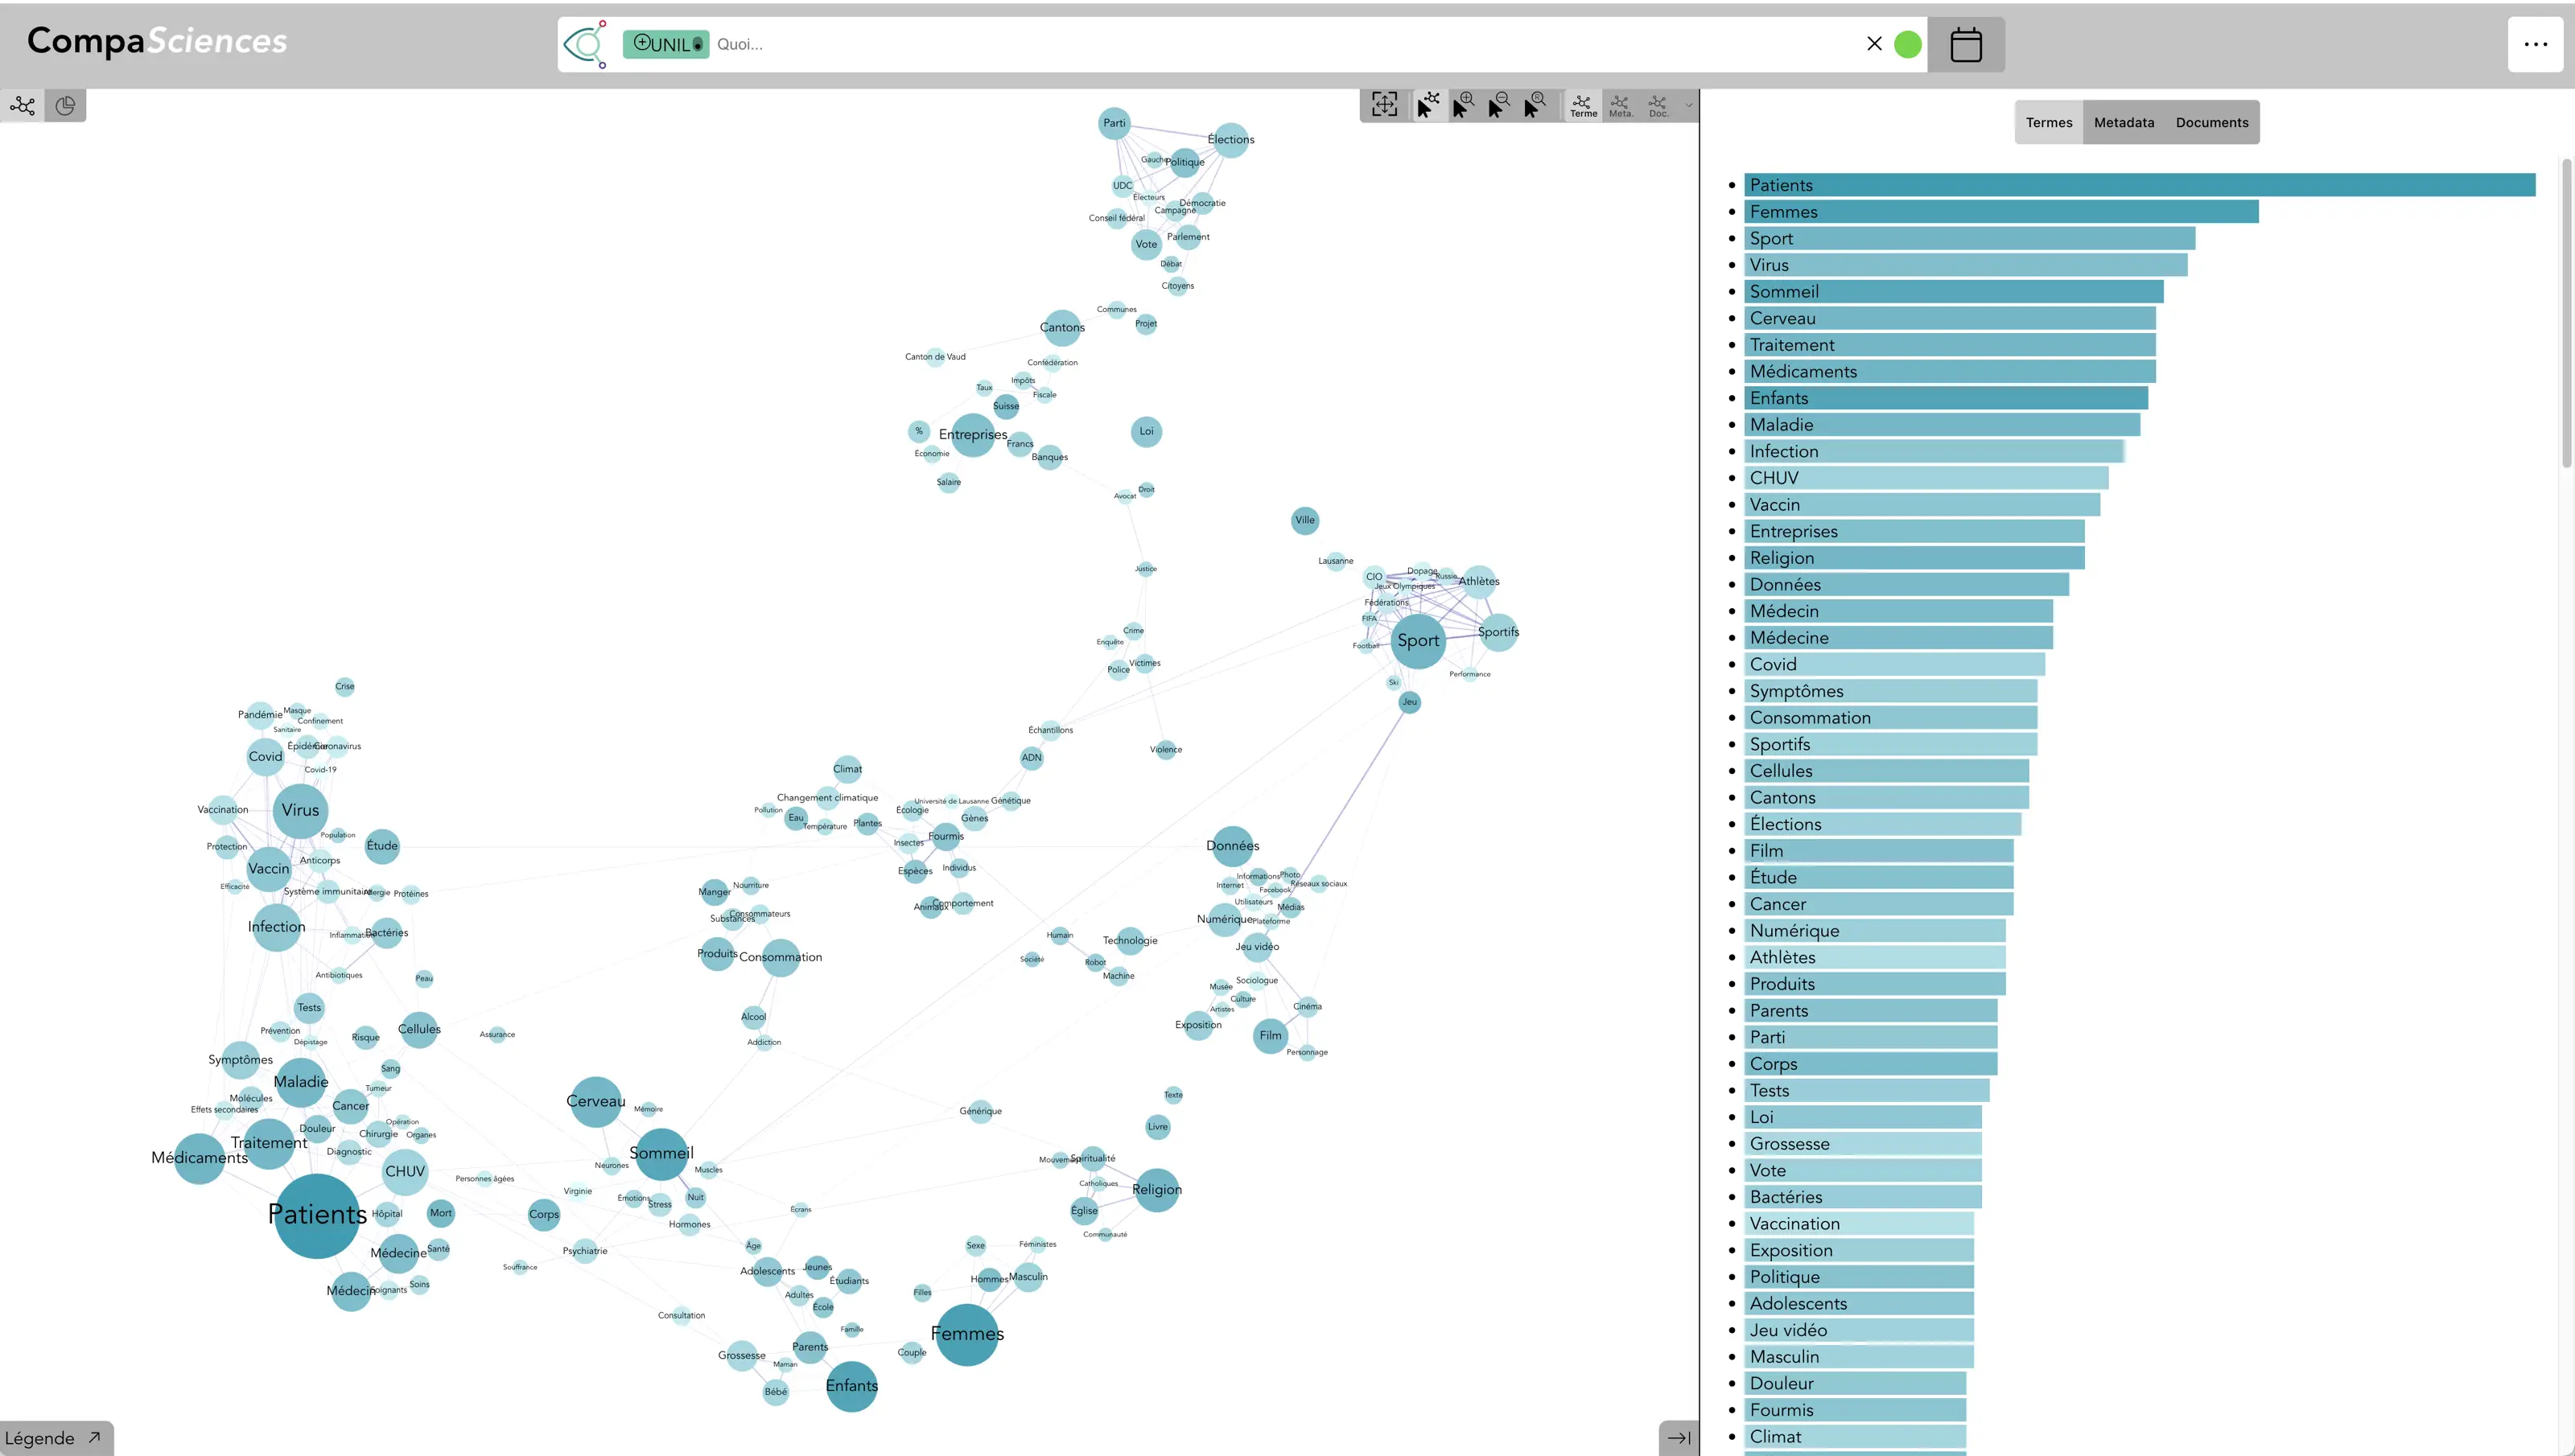
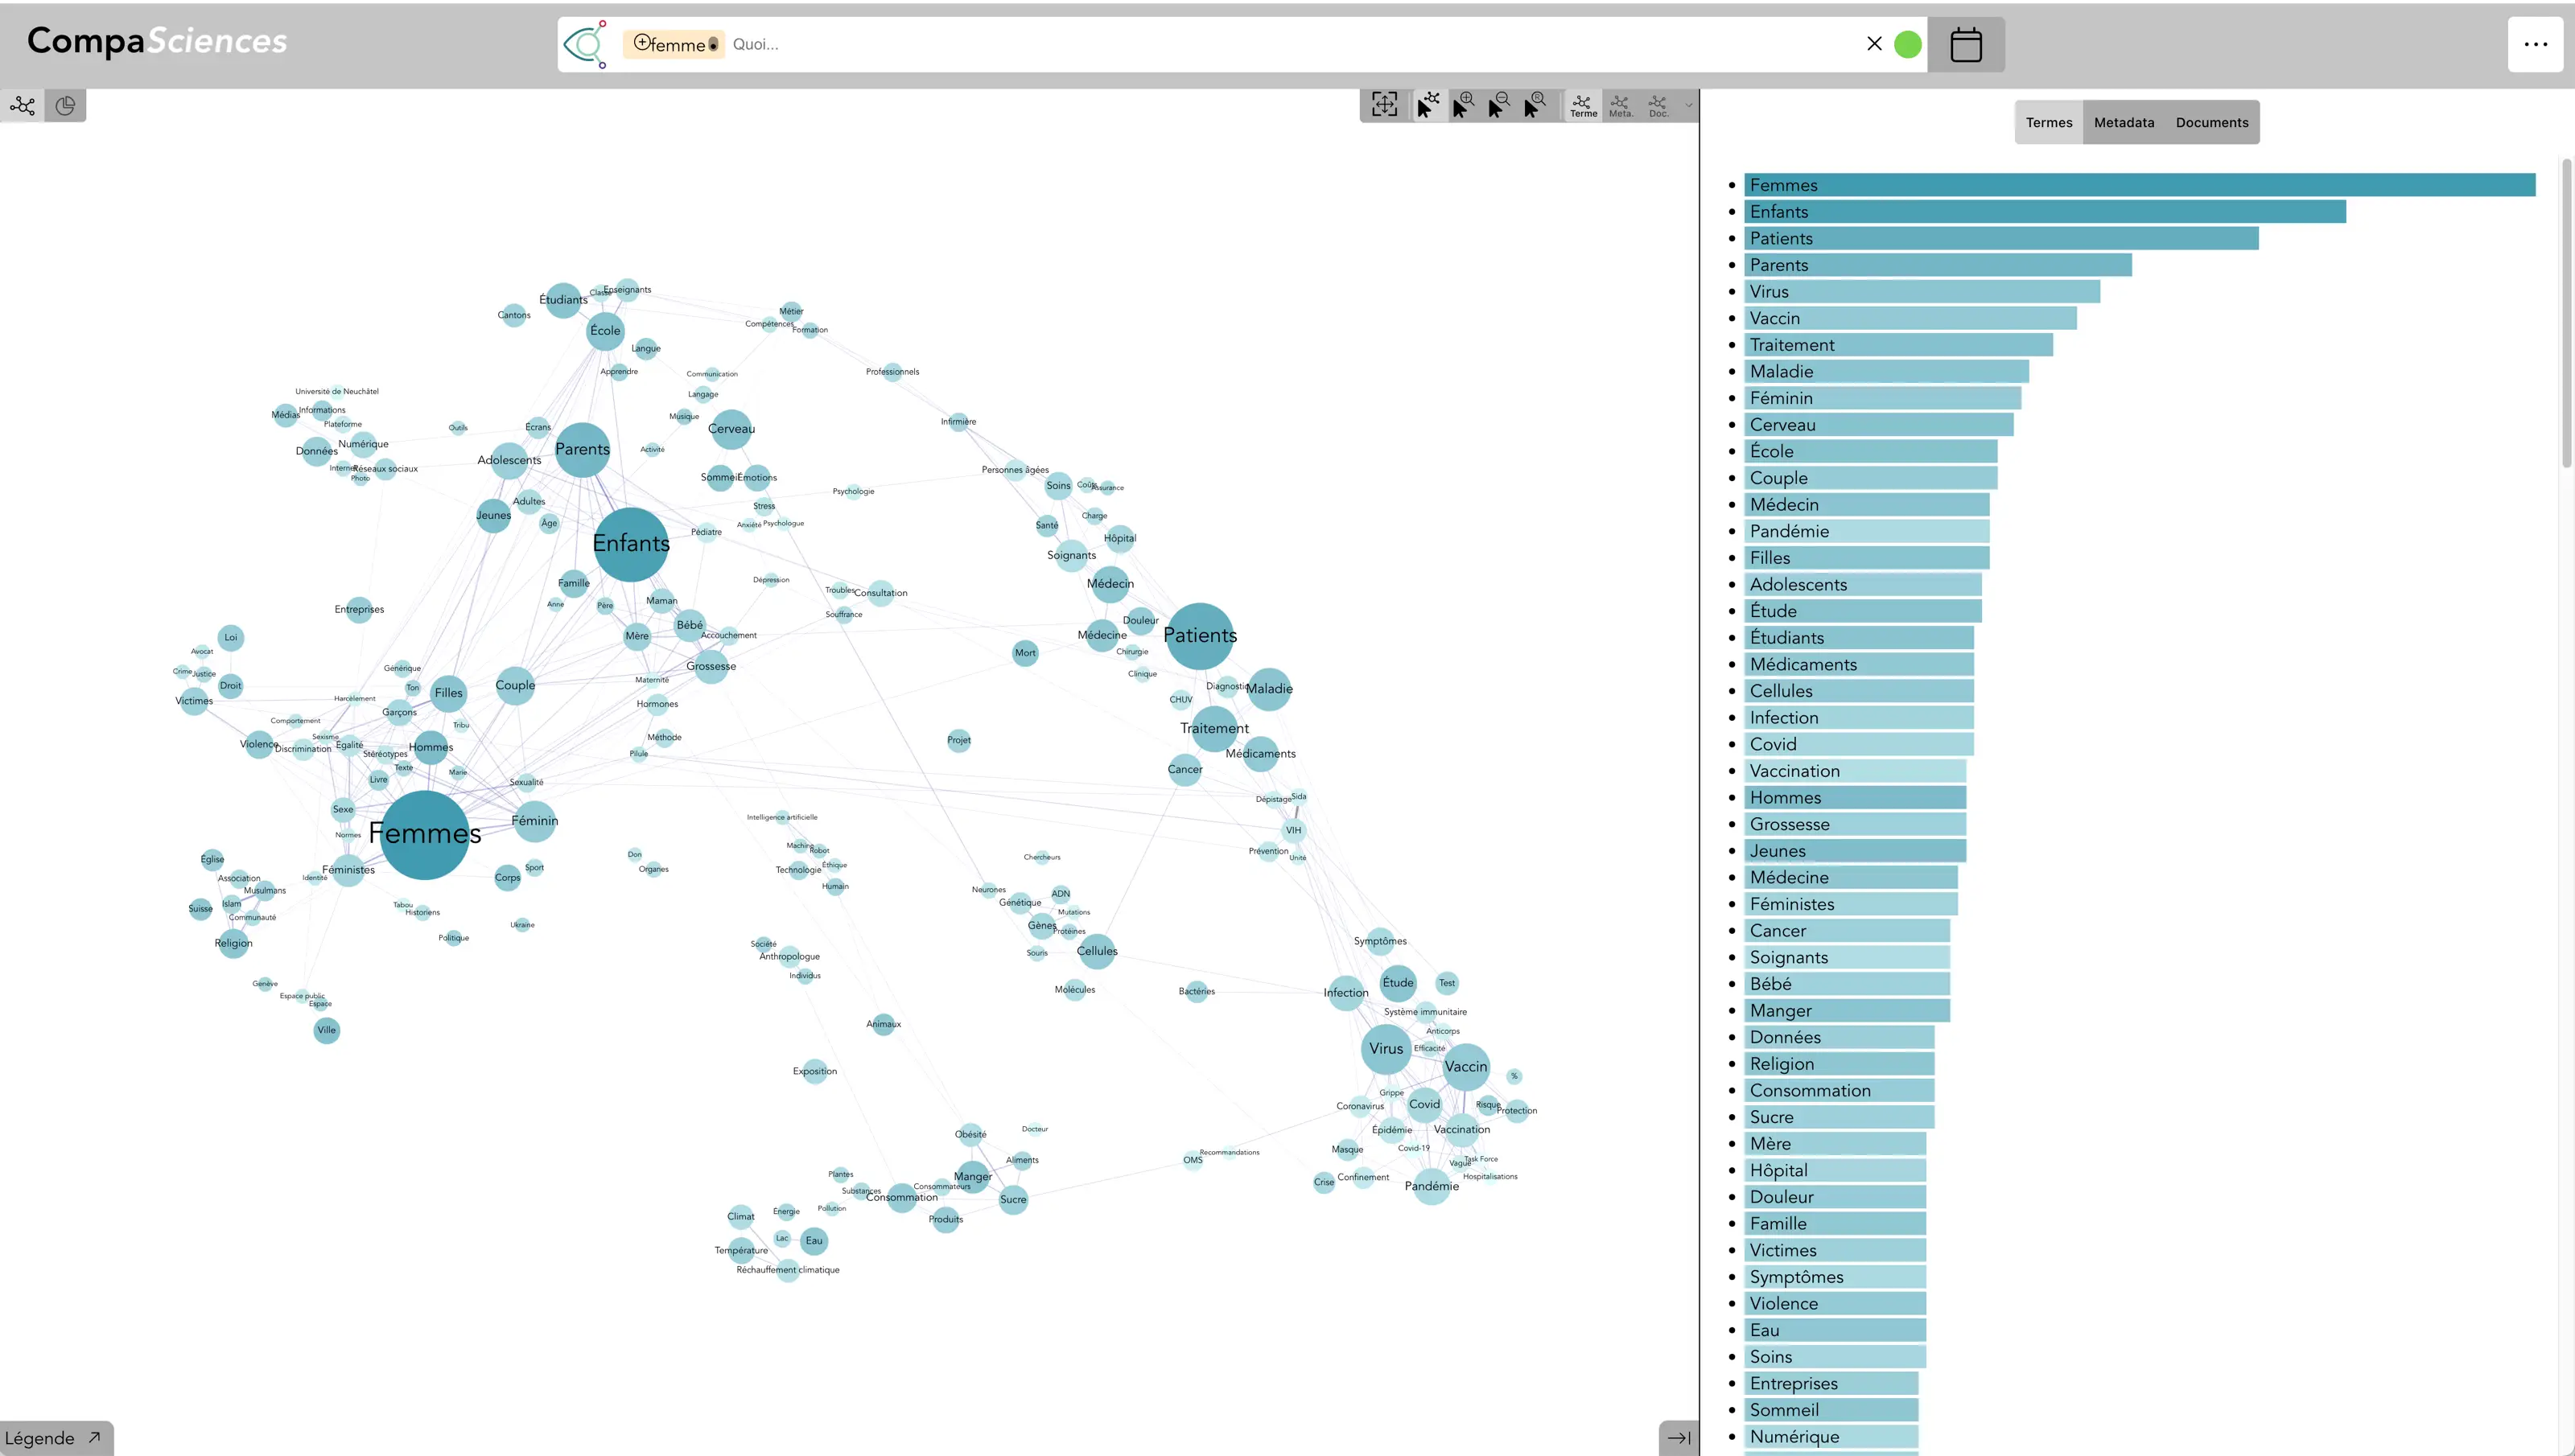
Exemples sur la durabilité
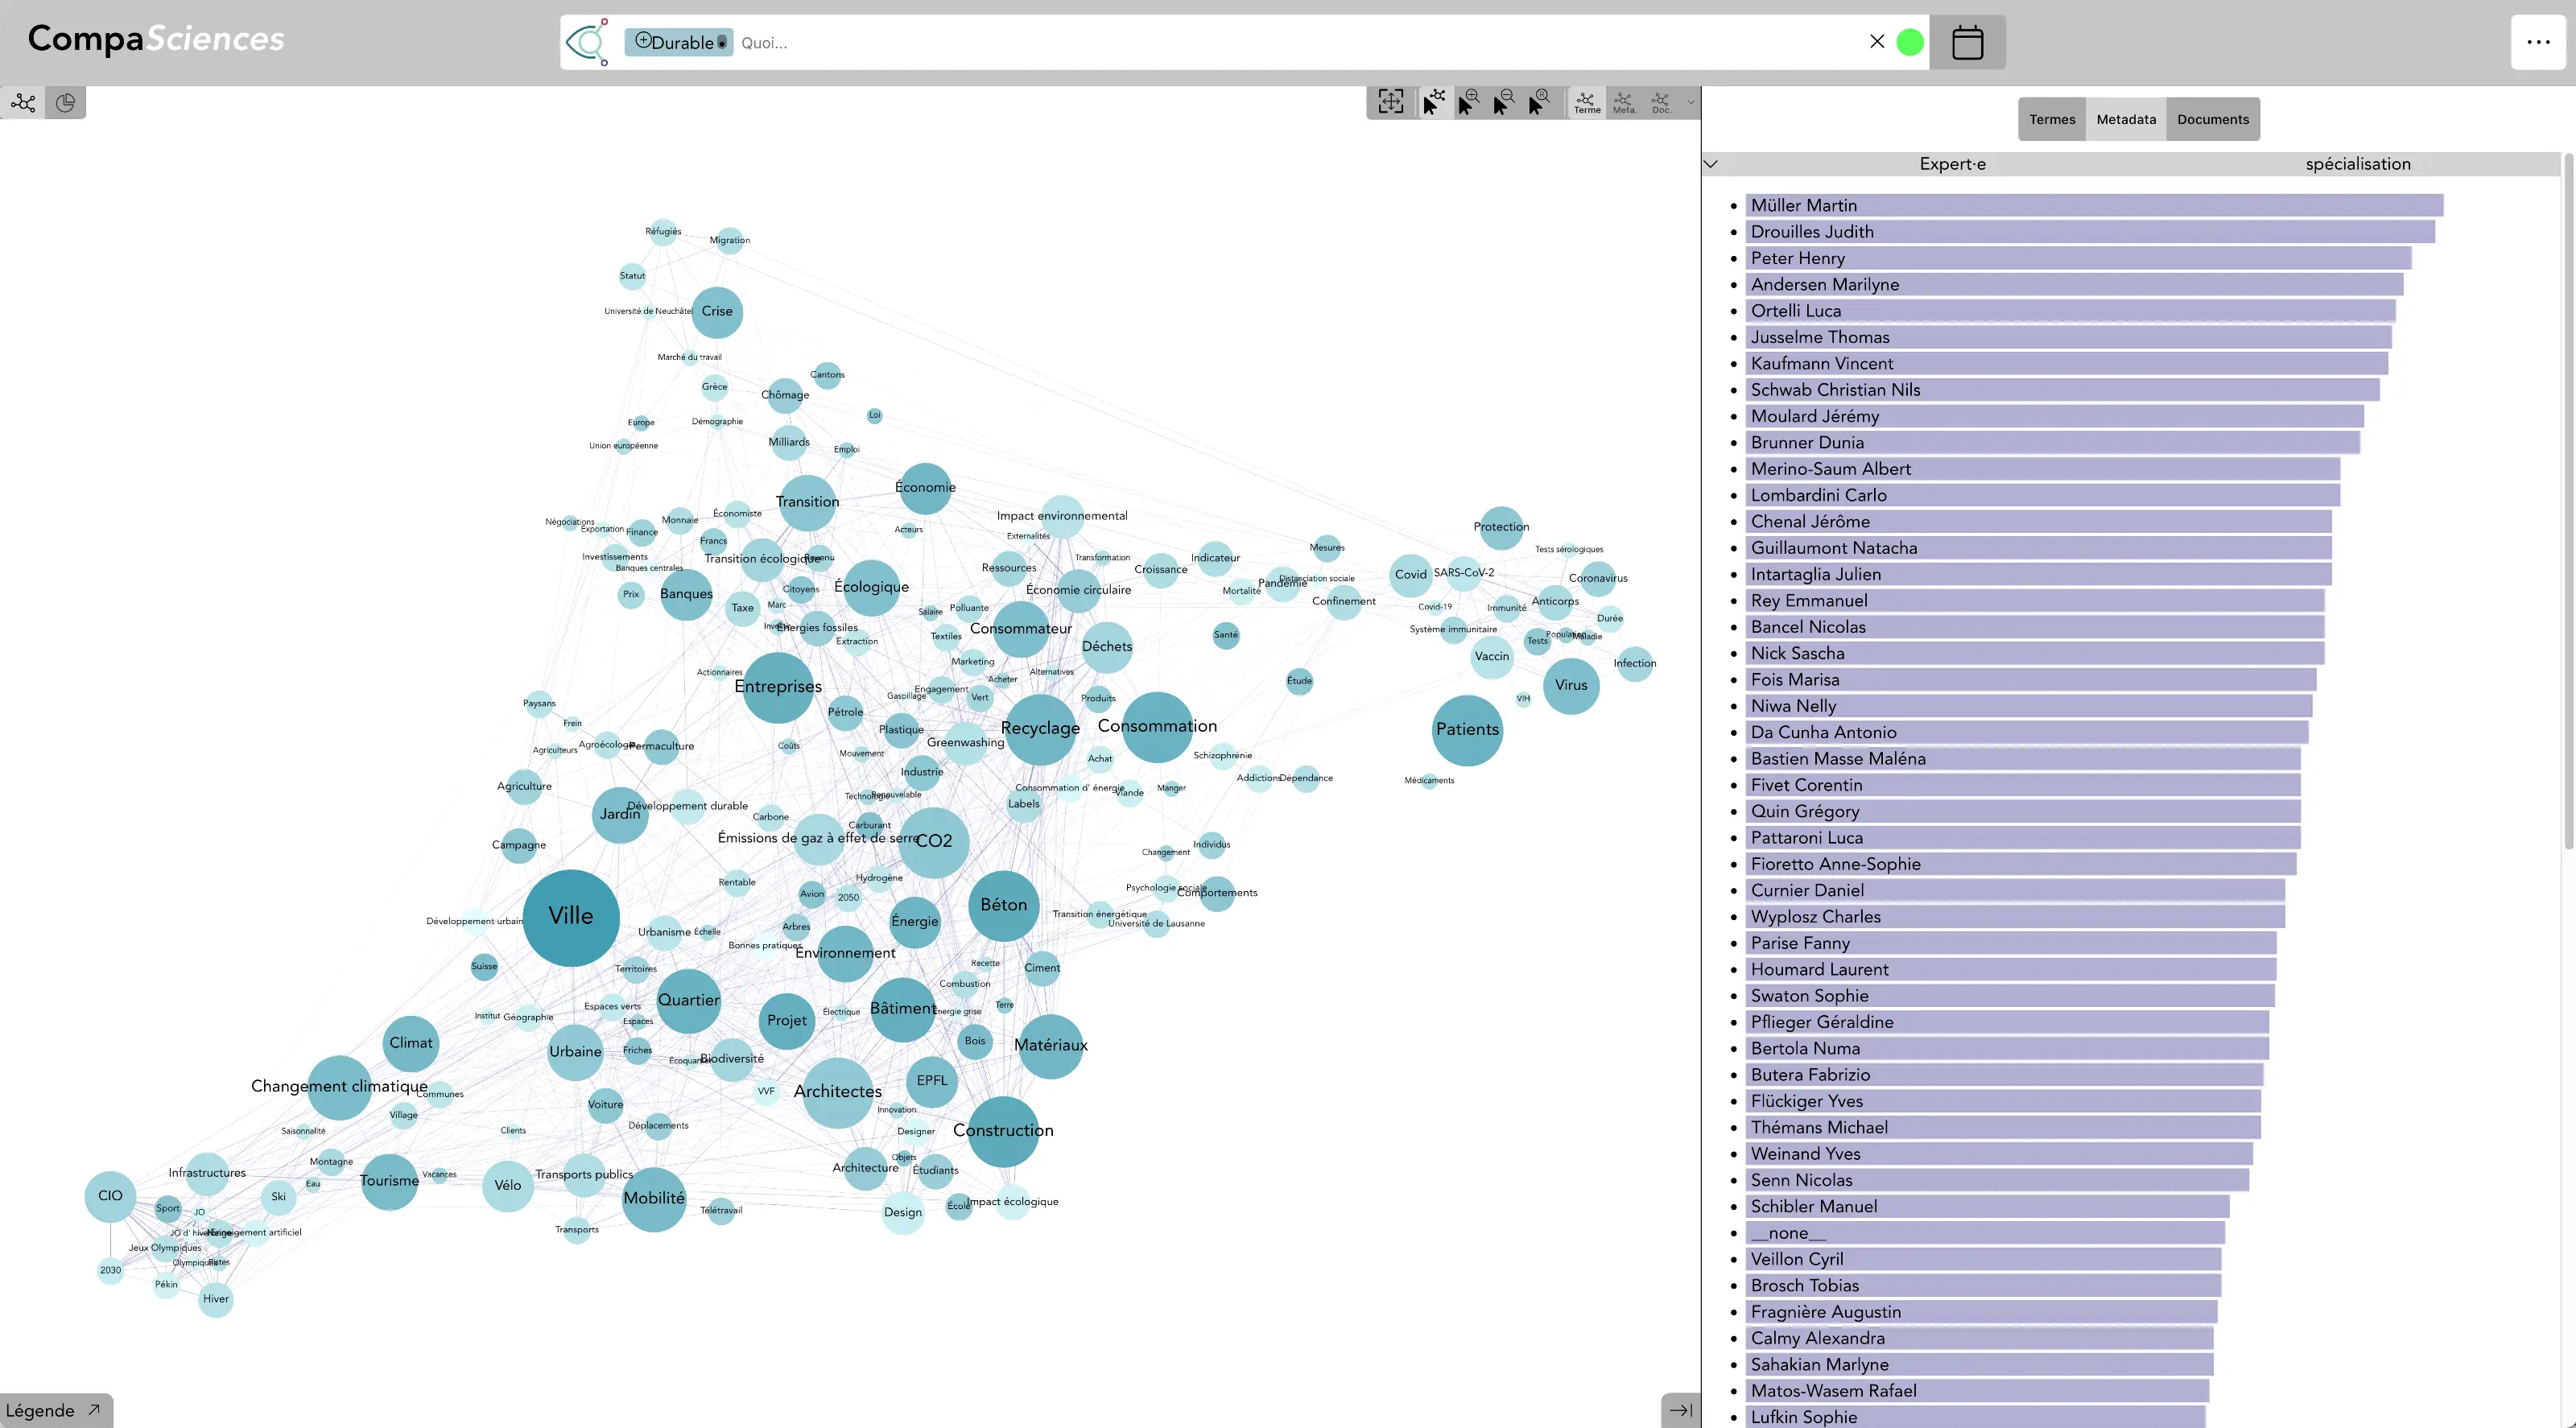
Le terme durabilité est automatiquement associé au champ sémantique de « durable »
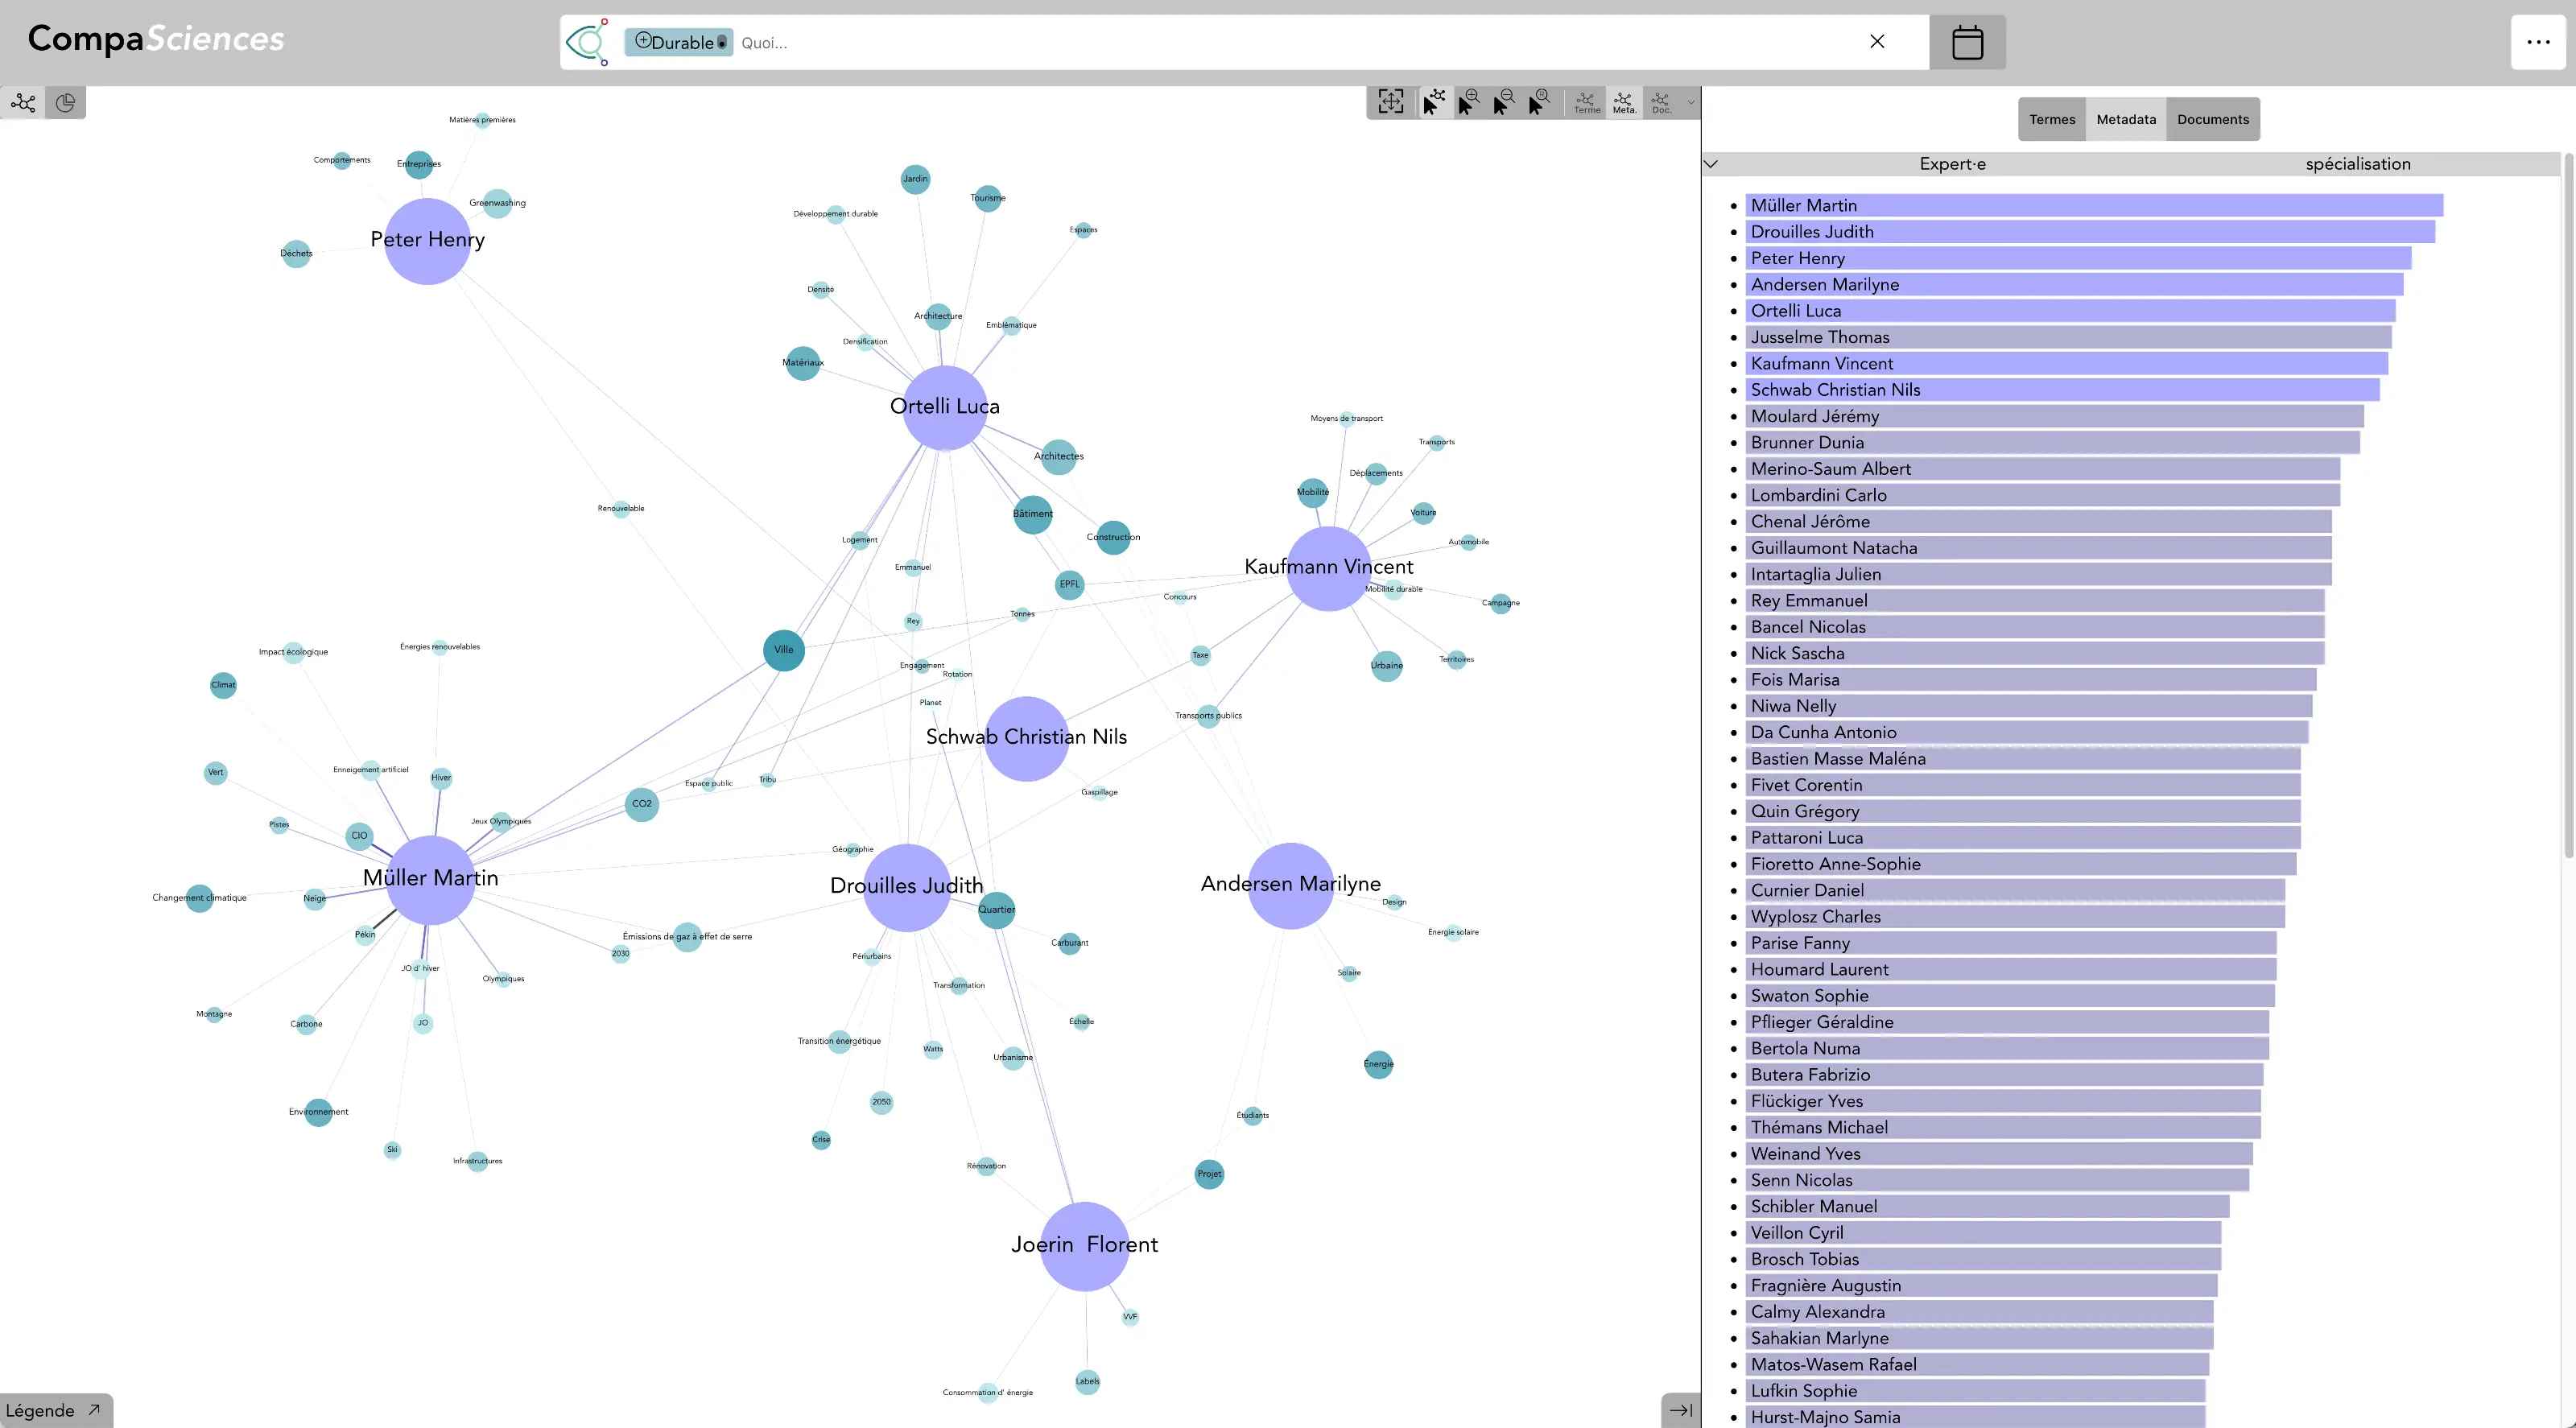
Il est possible de spatialiser les expert·e·s selon leur spécialisation
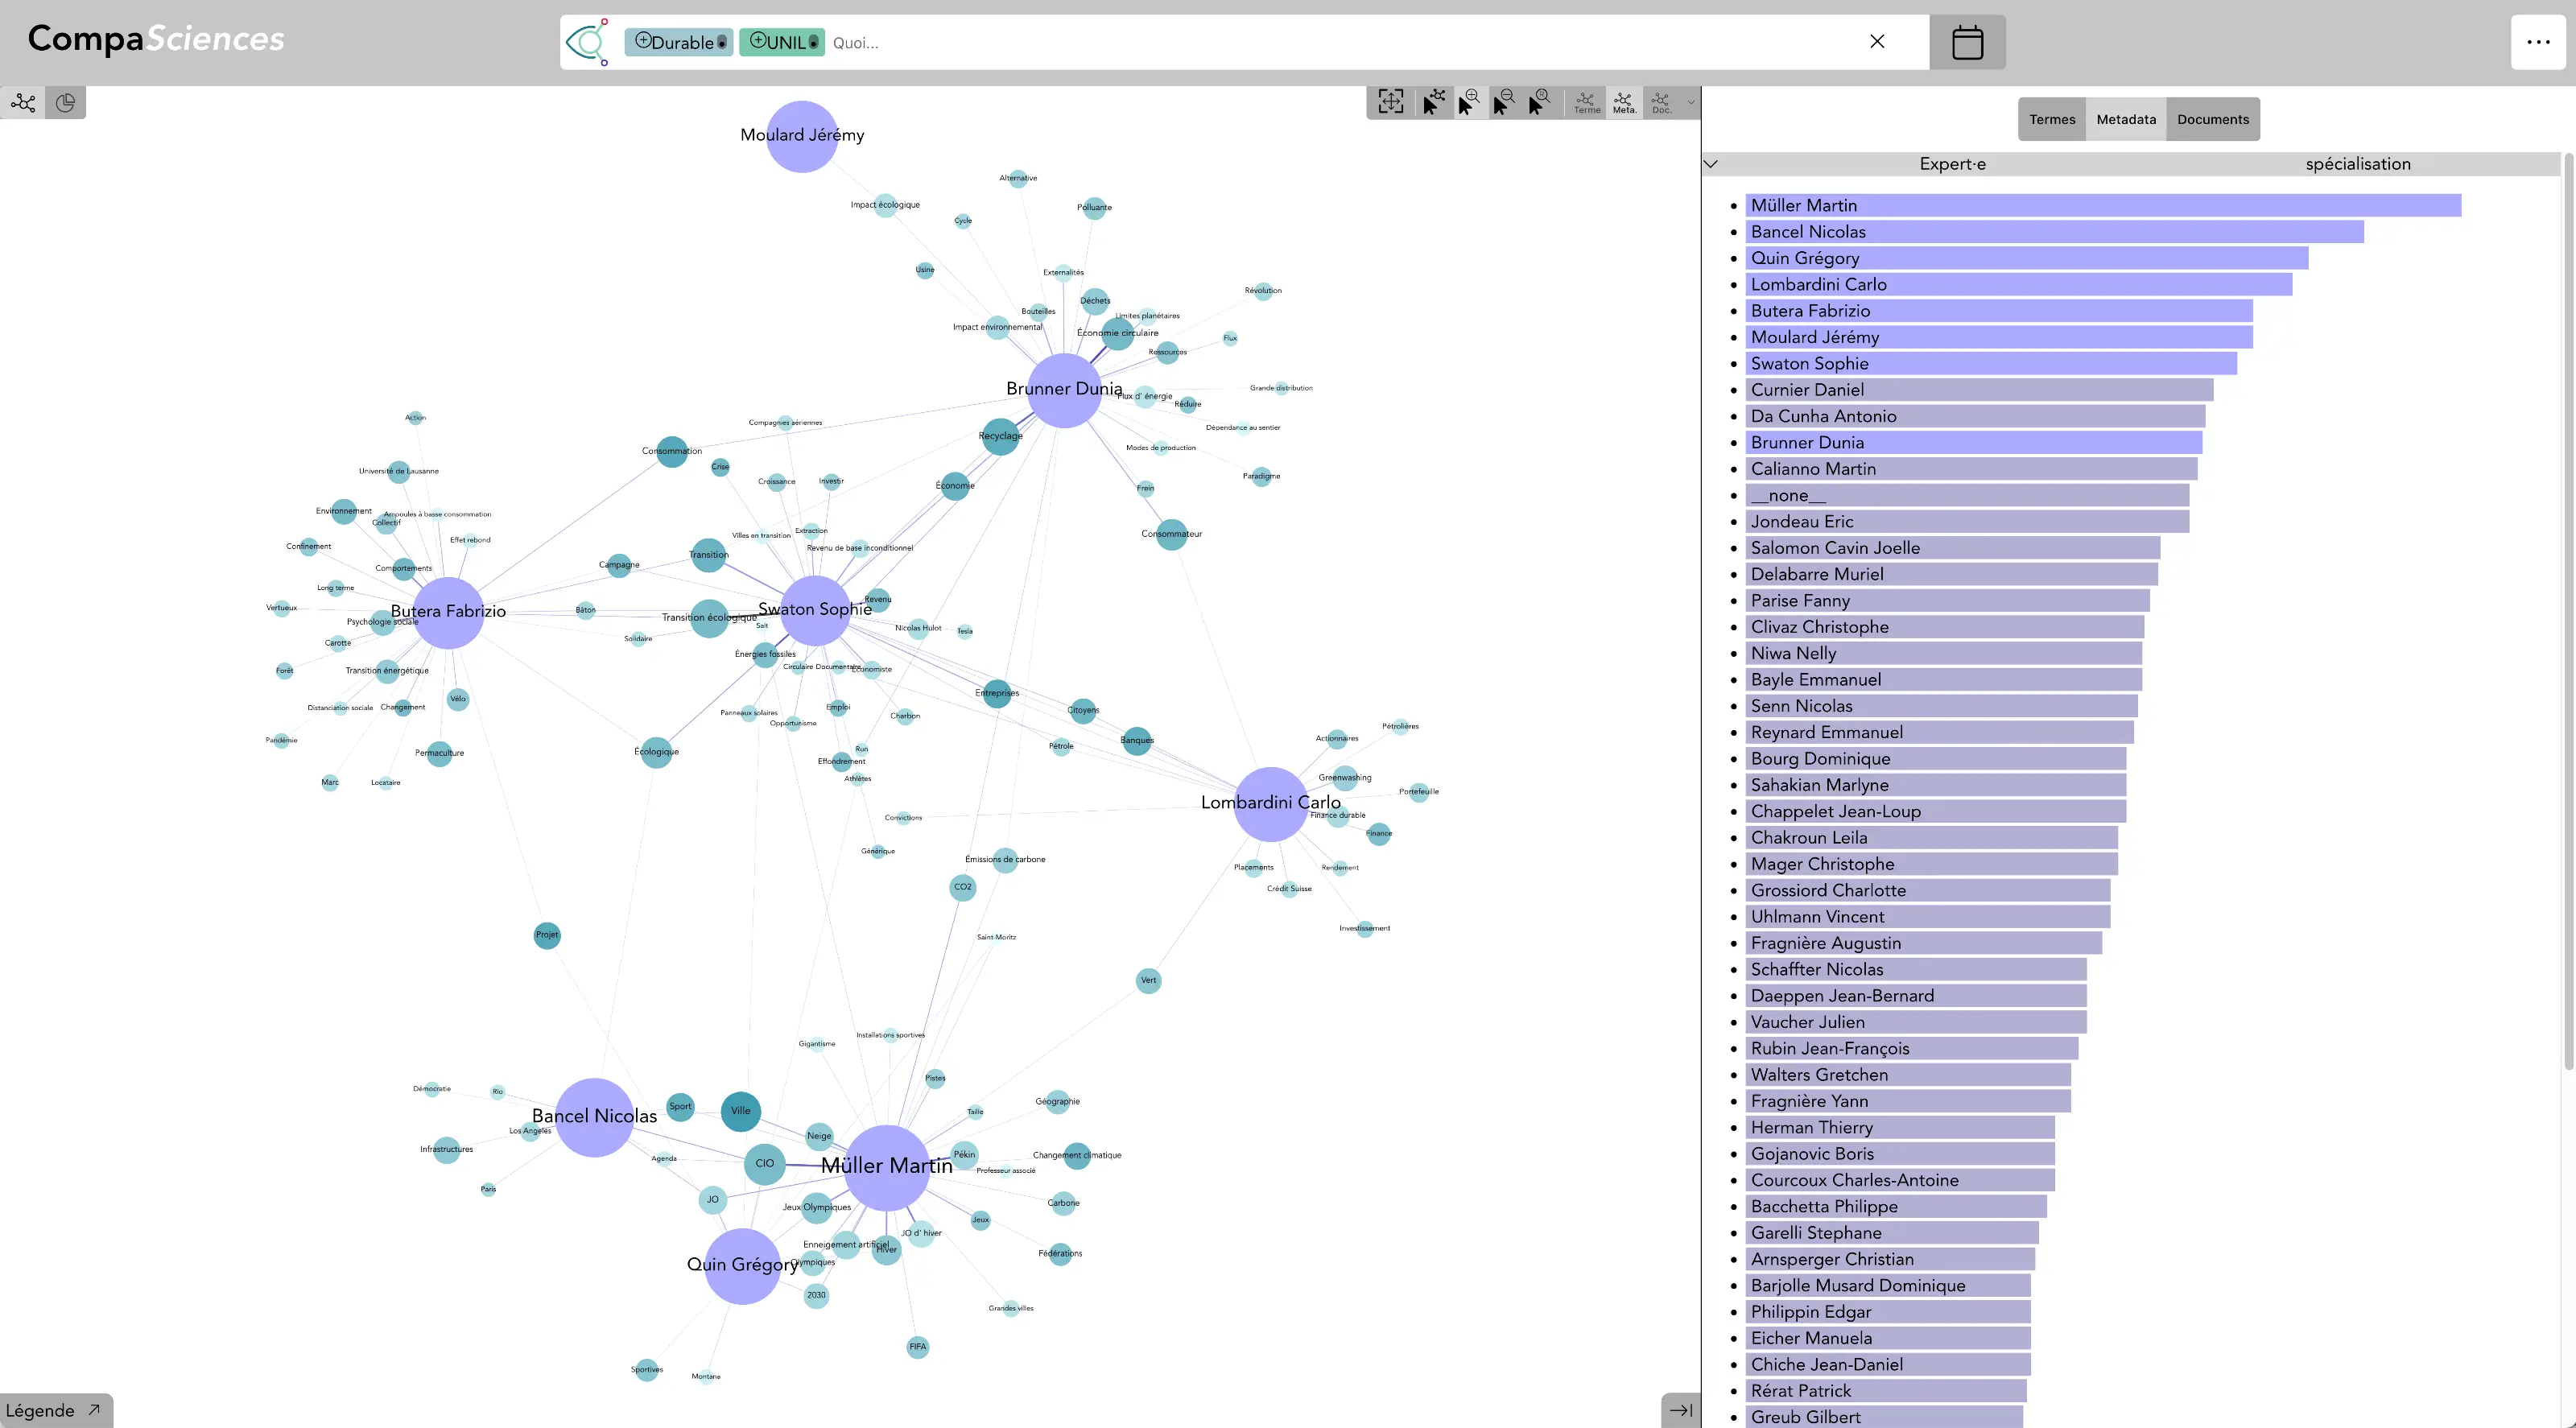
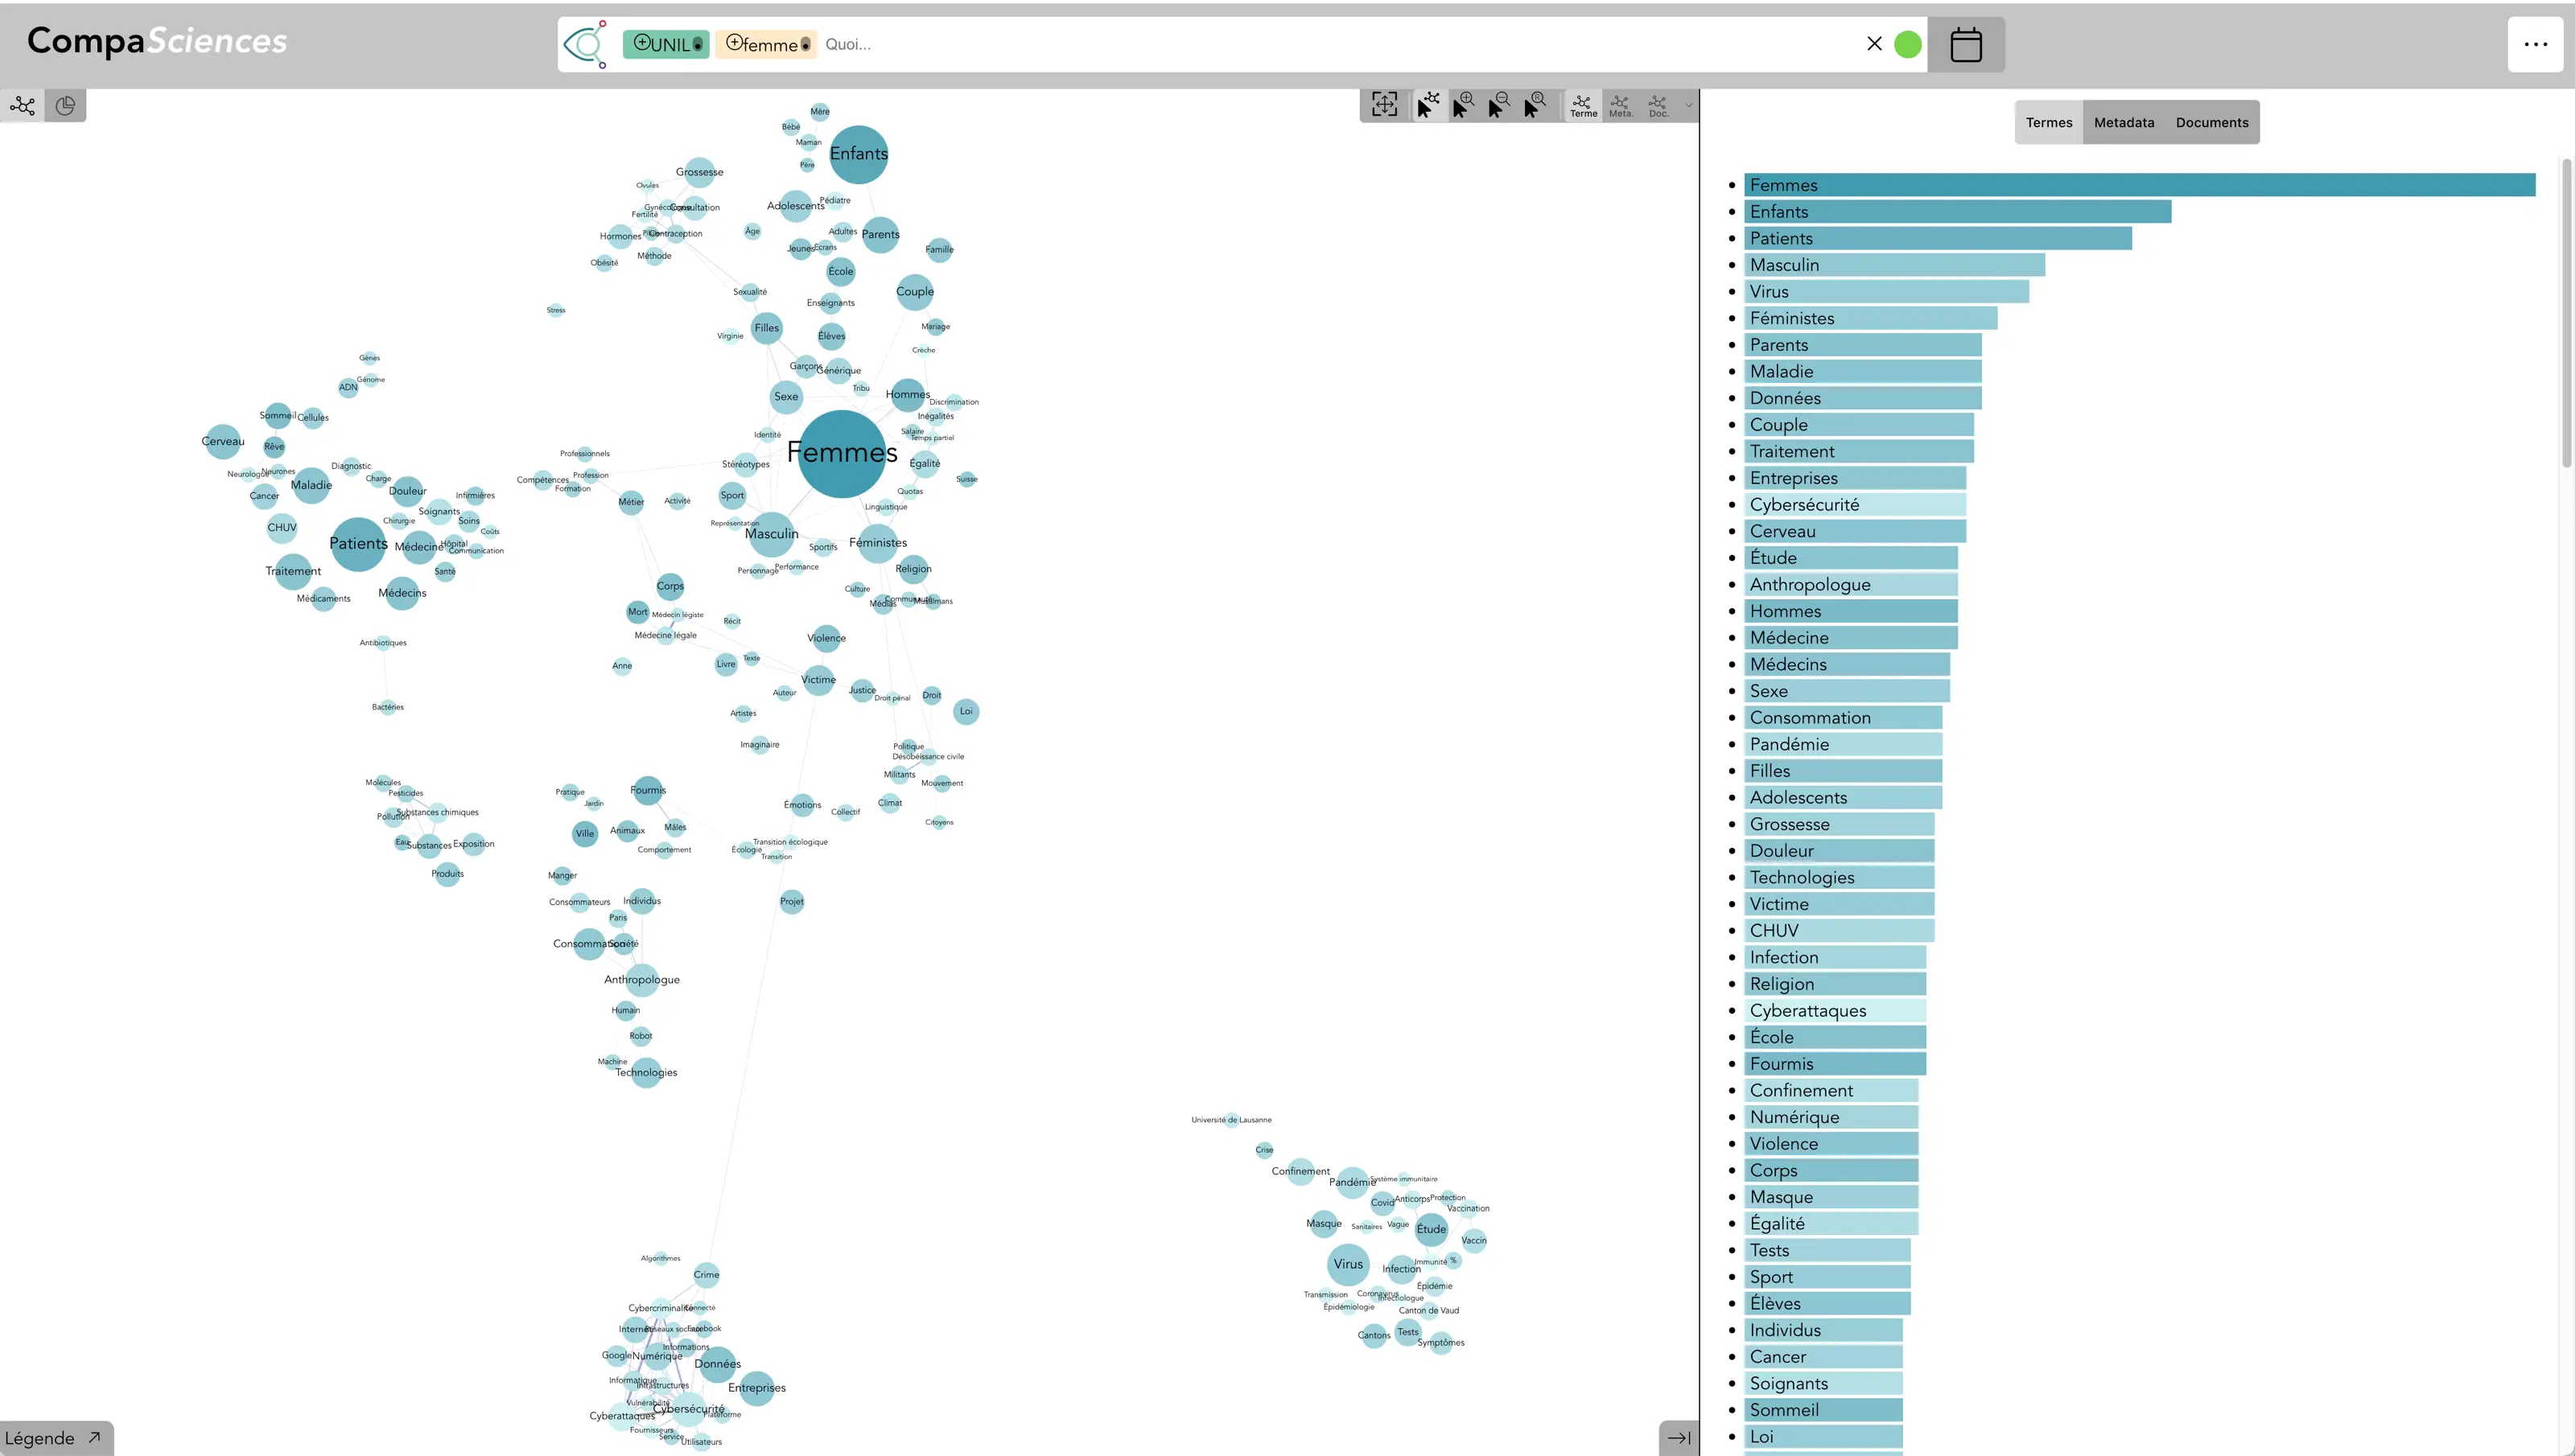
En ajoutant l’institution UNIL à la recherche, seul·e·s les expert·e·s de l’UNIL sont représenté·e·s
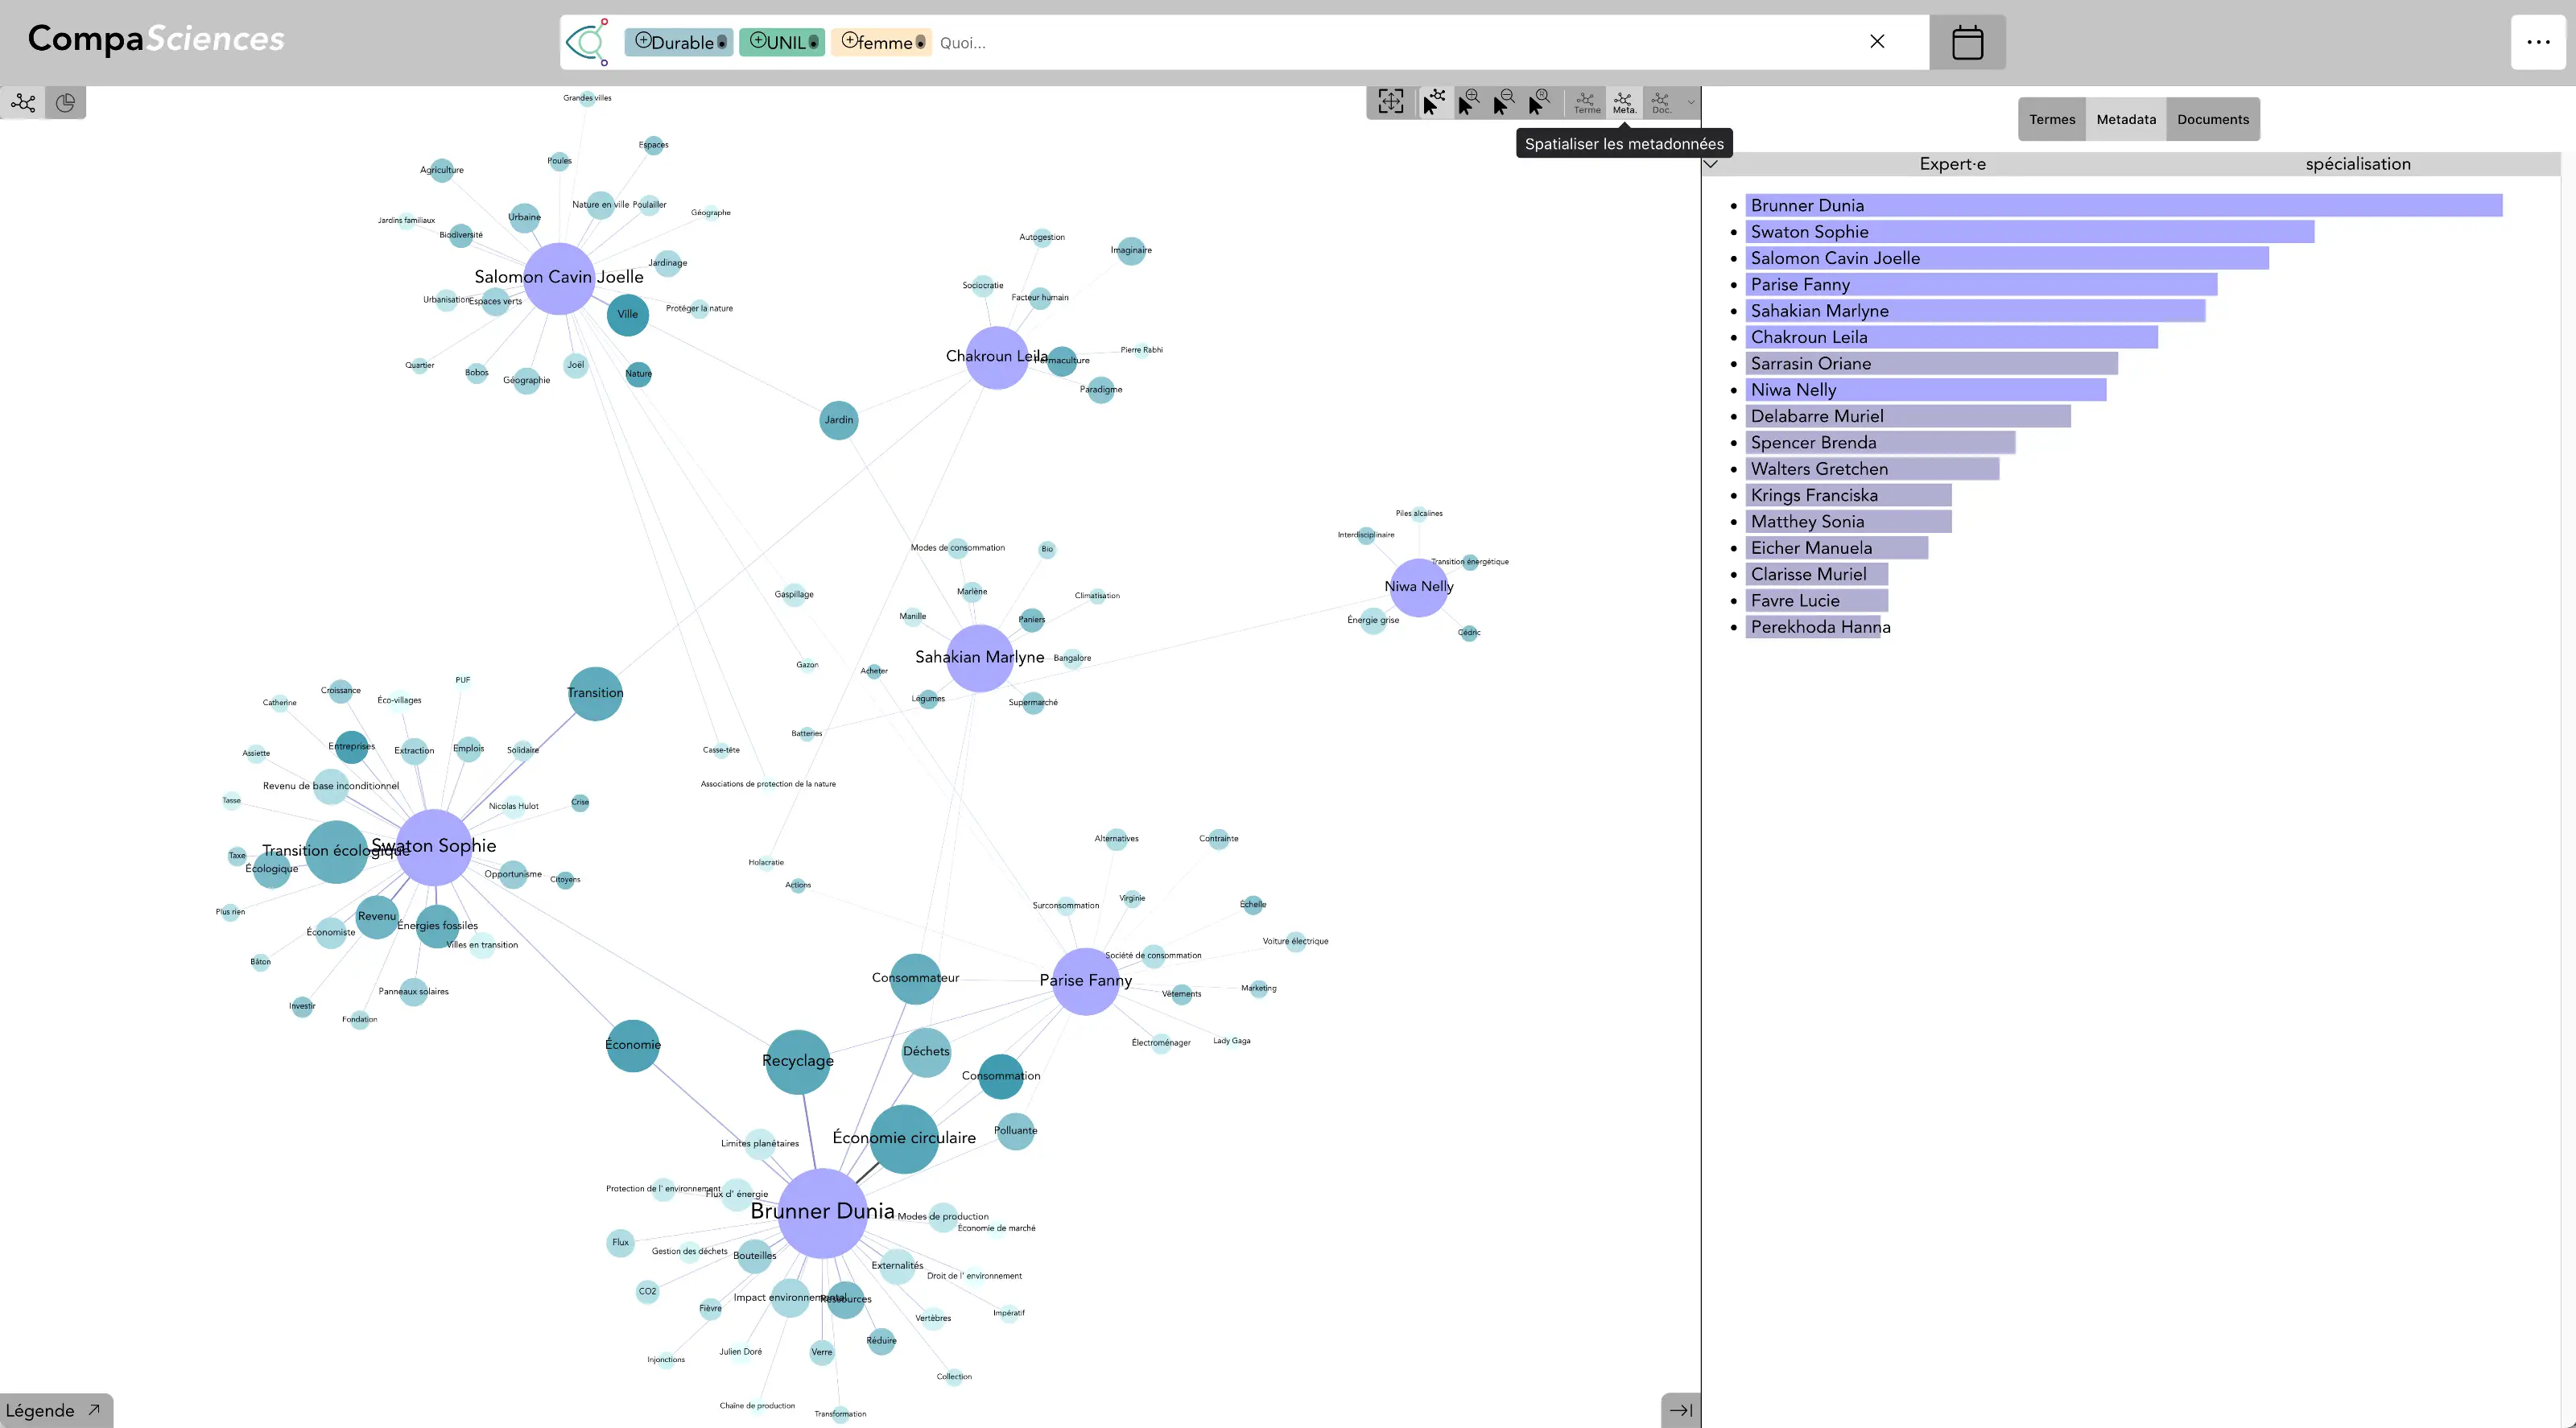
En ajoutant le genre Femme, seules les expertes de l’UNIL sont représentées
Interface
Recherche
Limiter la recherche (période)
Permet de restreindre la recherche à une période.
Remplacer la recherche
Remplace la recherche par un terme de l’environnement sémantique.
Ajouter un terme
Ajoute directement un terme à la recherche depuis le réseau sémantique.
Supprimer un terme
Supprime directement un terme de la recherche depuis le réseau sémantique.
Vues
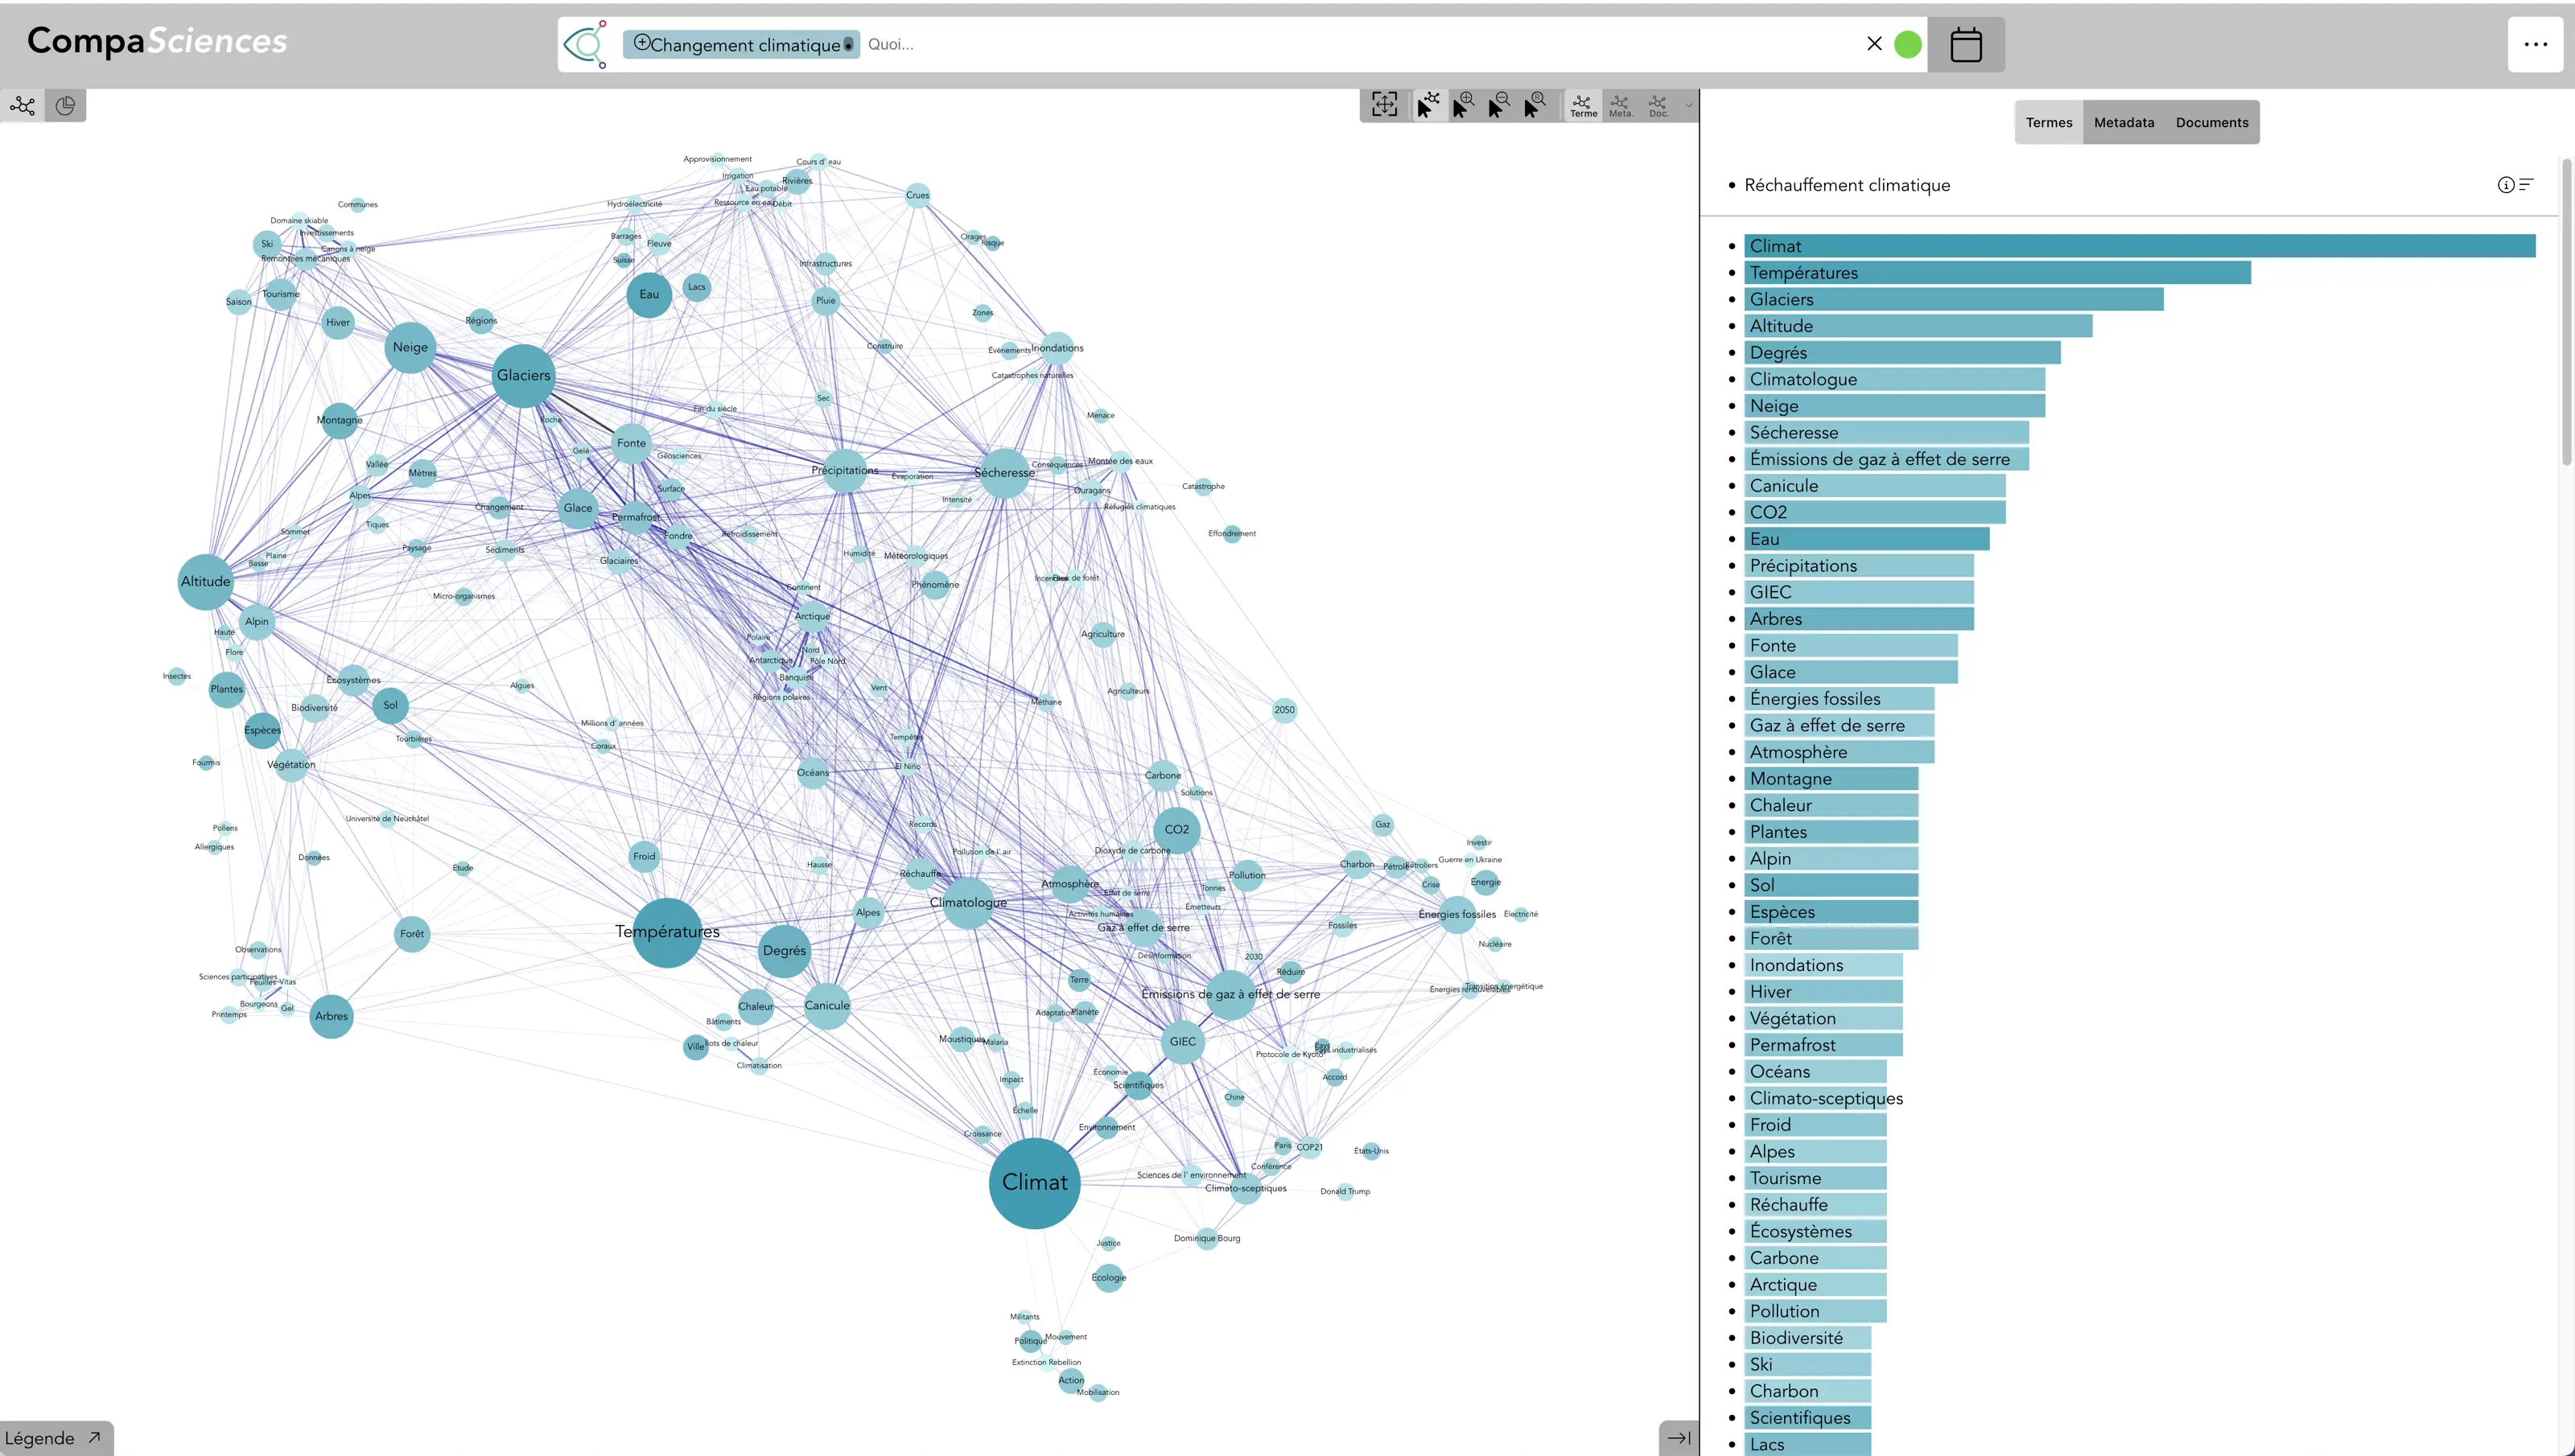
Vue du réseau sémantique
Lorsque le compte y est autorisé, permet de passer du Dashboard au réseau sémantique.
Vue du Dashboard
Lorsque le compte y est autorisé, permet de passer du réseau sémantique au Dashboard.
Légende
Ouvre la légende.
Fermeture du panel
Ferme le panneau d’information.
Recadrage automatique
Permet de recadrer automatiquement le réseau sémantique à la taille de l’écran.
Focus sur un terme
Met en évidence les termes reliés au terme choisi dans le réseau et fait défiler la liste des termes jusqu’à lui.
Spatialiser les termes
Positionne les termes selon leur proximité sémantique.
Spatialiser les documents
Positionne les documents selon leur proximité sémantique.
Spatialiser les métadonnées
Positionne dans le réseau de termes la métadonnée sélectionnée dans le panel. Privilégie la relation entre les termes et les expert·e·s. La relation entre les termes est donc moins fiable.
Réglages
Permet d’accéder au compte de connexion et aux réglages avancés.
- Connexion (identifiant) et déconnexion
- Langue de l’interface (français et anglais)
- Paramètres avancés
- Paramètres visuels
- Paramètres de placement des nœuds
- Paramètres de placement des métadonnées
- Réexécution de la spatialisation (pour celles qui ont une composante aléatoire, comme UMAP).
- Choix de l’algorithme de spatialisation (UMAP, ForceAtlas2 et MDS)
Panel
Termes
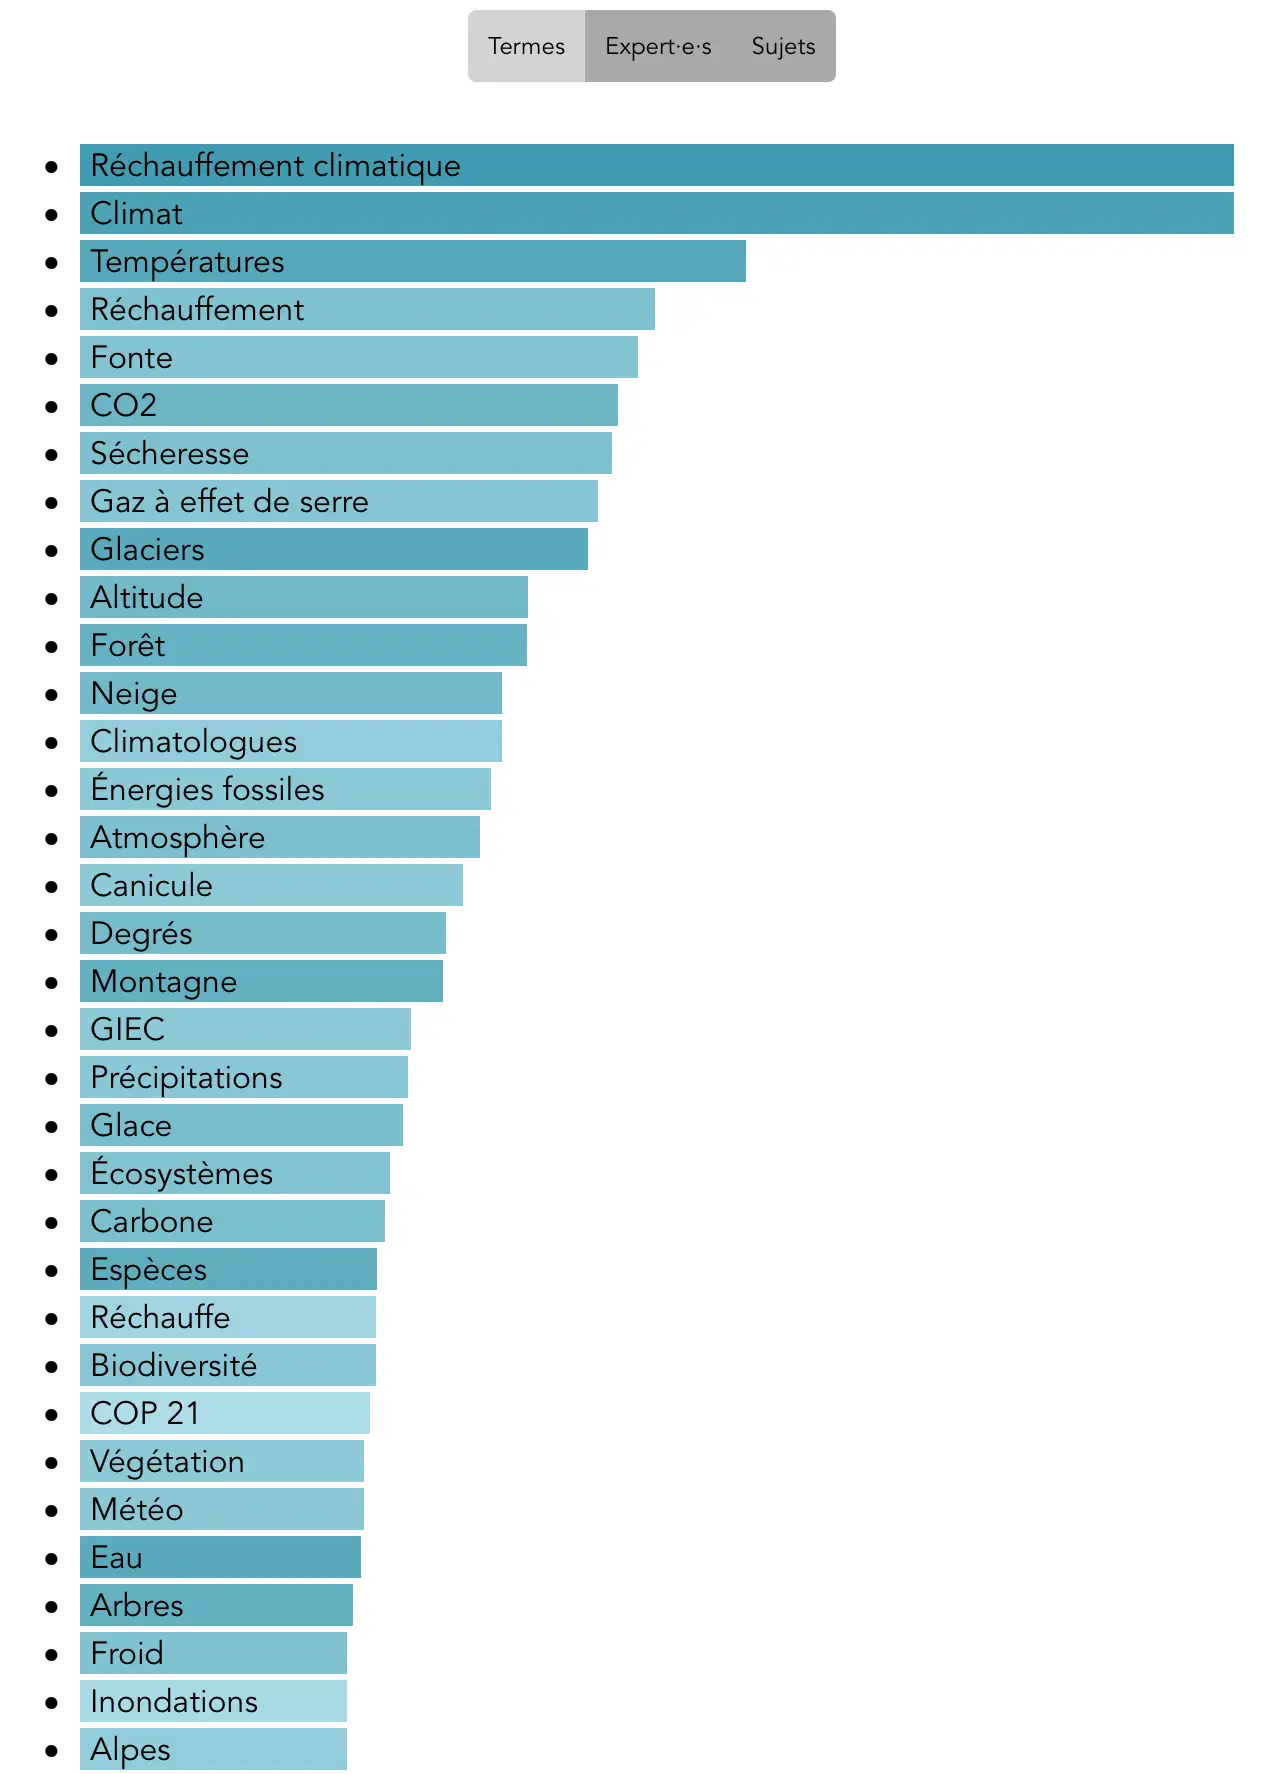
Présente la liste des termes les plus pertinents pour les critères de recherche (cf. Recherche).
La pertinence correspond à l’association spécifique des termes et non à leur occurrence. Des termes très occurrents, mais peu spécifiques à cette recherche, seront donc moins bien classés que des termes moins occurrents, mais spécifiques à cette recherche.
- La pertinence est représentée par la barre horizontale.
- L’occurrence est représentée par l’intensité de la couleur.
Détails des termes

Pour chaque terme, il est possible d’approfondir la recherche ou de disposer d’informations complémentaires.
Localise ce terme dans le réseau
Focus sur ce terme dans le réseau (n’active que les liens relatifs à ce terme)
Ajoute ce terme à la recherche
Remplace la recherche par ce terme
Informations sur ce terme
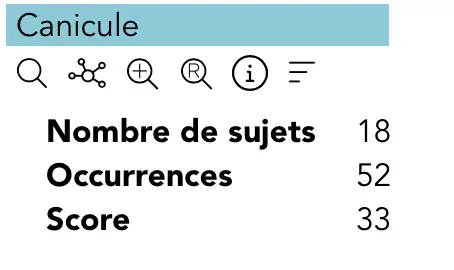
Présente le nombre de sujets avec ce terme pour la recherche considérée, le nombre d’occurrences et le score de pertinence pour ce terme (sur 100).
Liste des termes équivalents
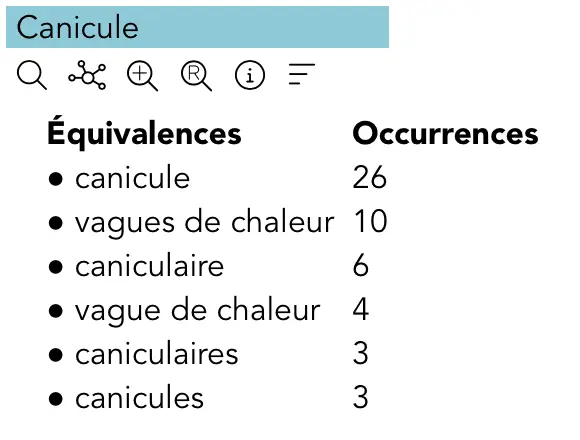
Présente la liste des termes équivalents ainsi que leurs occurrences pour la recherche considérée. Le terme le plus occurrent est présenté comme terme de référence dans la liste et dans le réseau.
Lien vers la page Wikipédia du terme
Expert·e·s
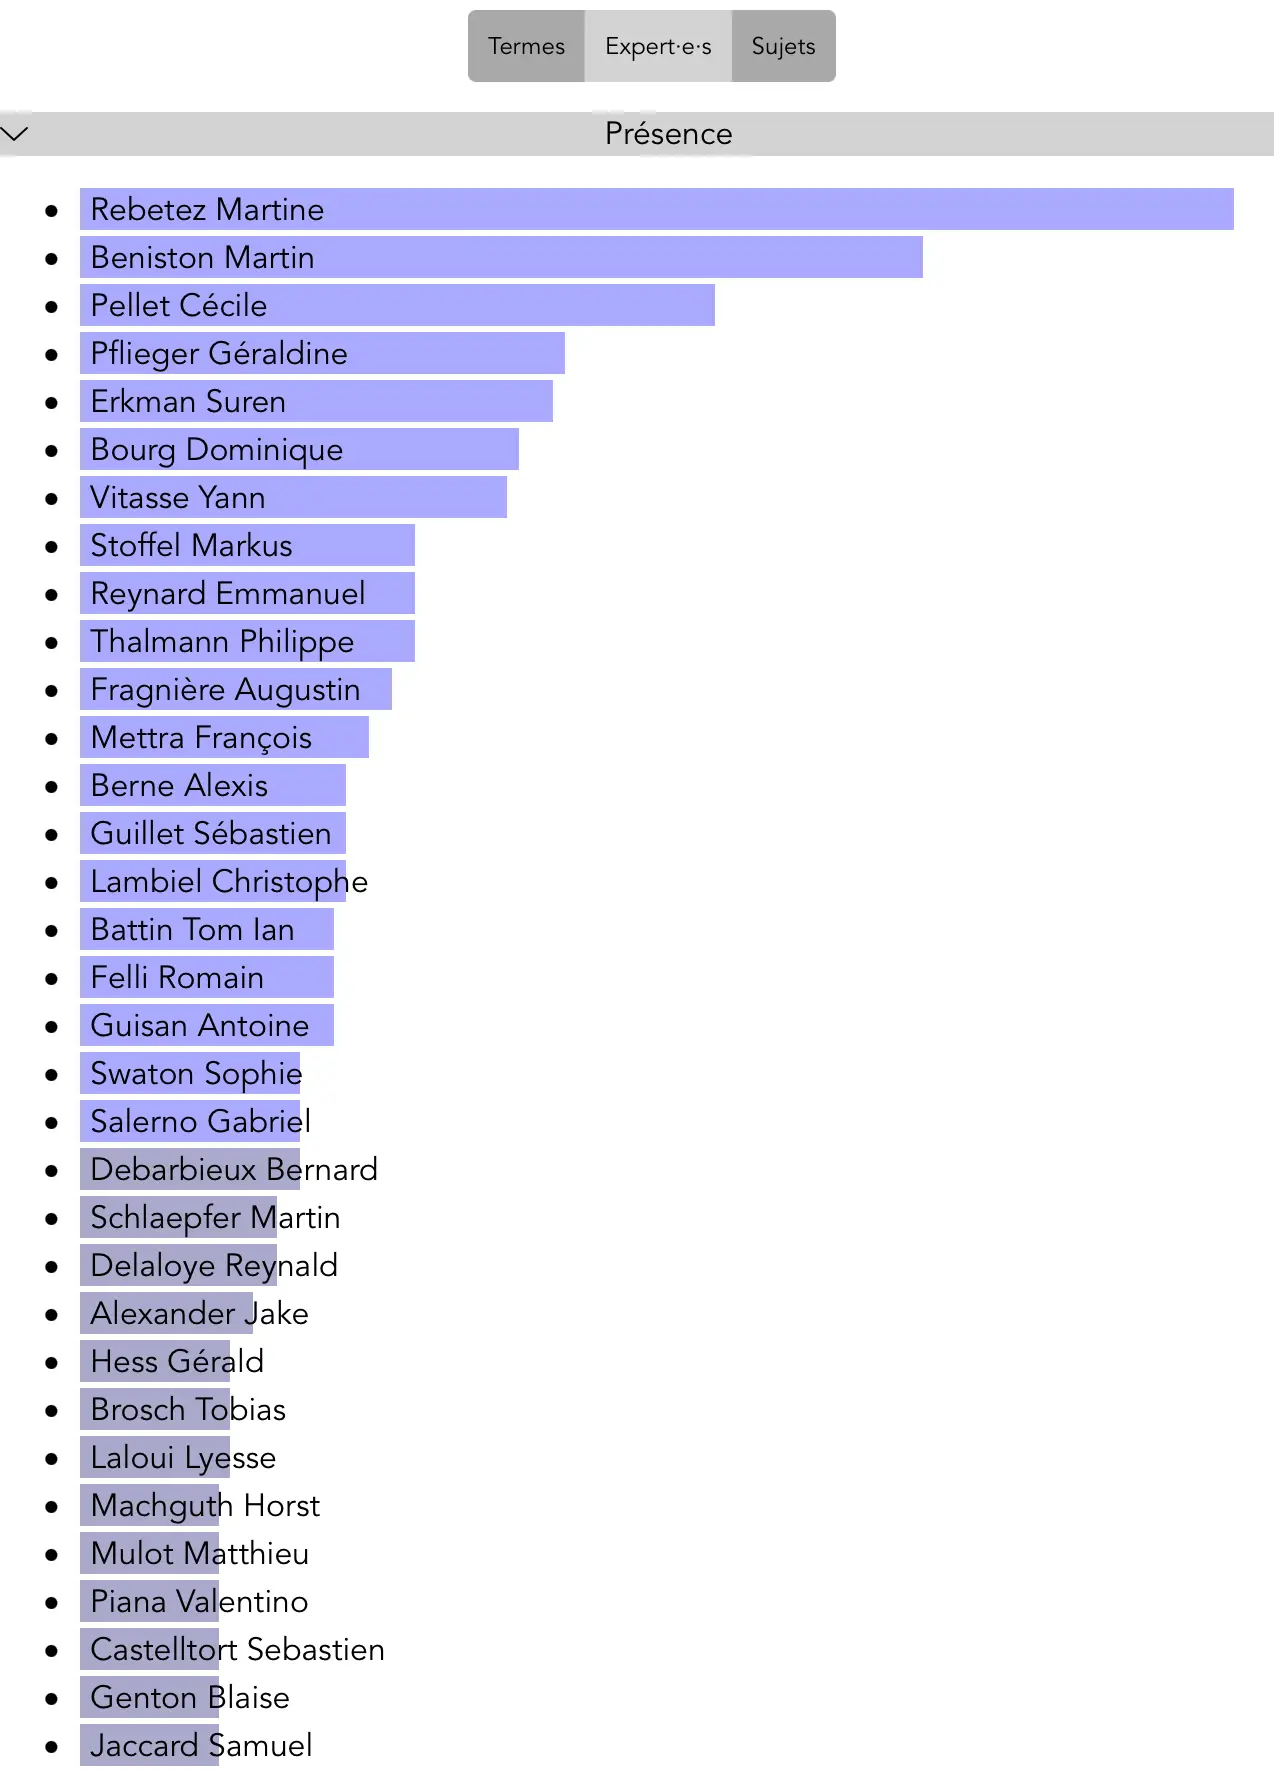
Présente la liste des expert·e·s les plus pertinent·e·s pour les critères de recherche (cf. Recherche).
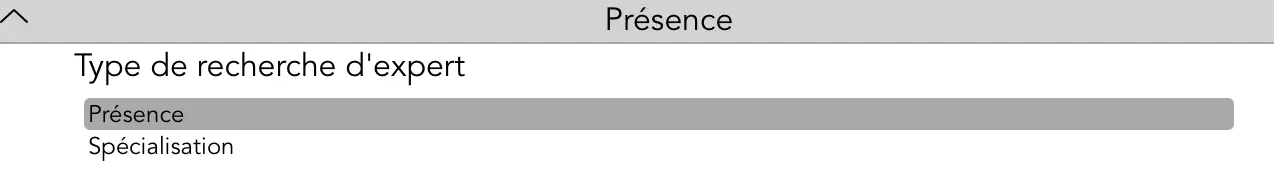
Les expert·e·s peuvent être classé·e·s selon deux approches (leur présence ou leur spécialisation).
- Présence : les expert·e·s sont classé·e·s selon leur présence dans les médias pour une recherche particulière (somme de leurs proximités avec le réseau sémantique).
- Spécialisation : les expert·e·s sont classé·e·s selon leur spécialisation dans les médias pour une recherche particulière (moyenne de leurs proximités avec le réseau sémantique).
Détails des expert·e·s
Détails

Pour chaque expert·e, il est possible d’approfondir la recherche et de disposer d’informations institutionnelles.
Ajoute cette métadonnée à la recherche
Remplace la recherche par cette métadonnée
Recherche cette métadonnée sur Google
Sujets
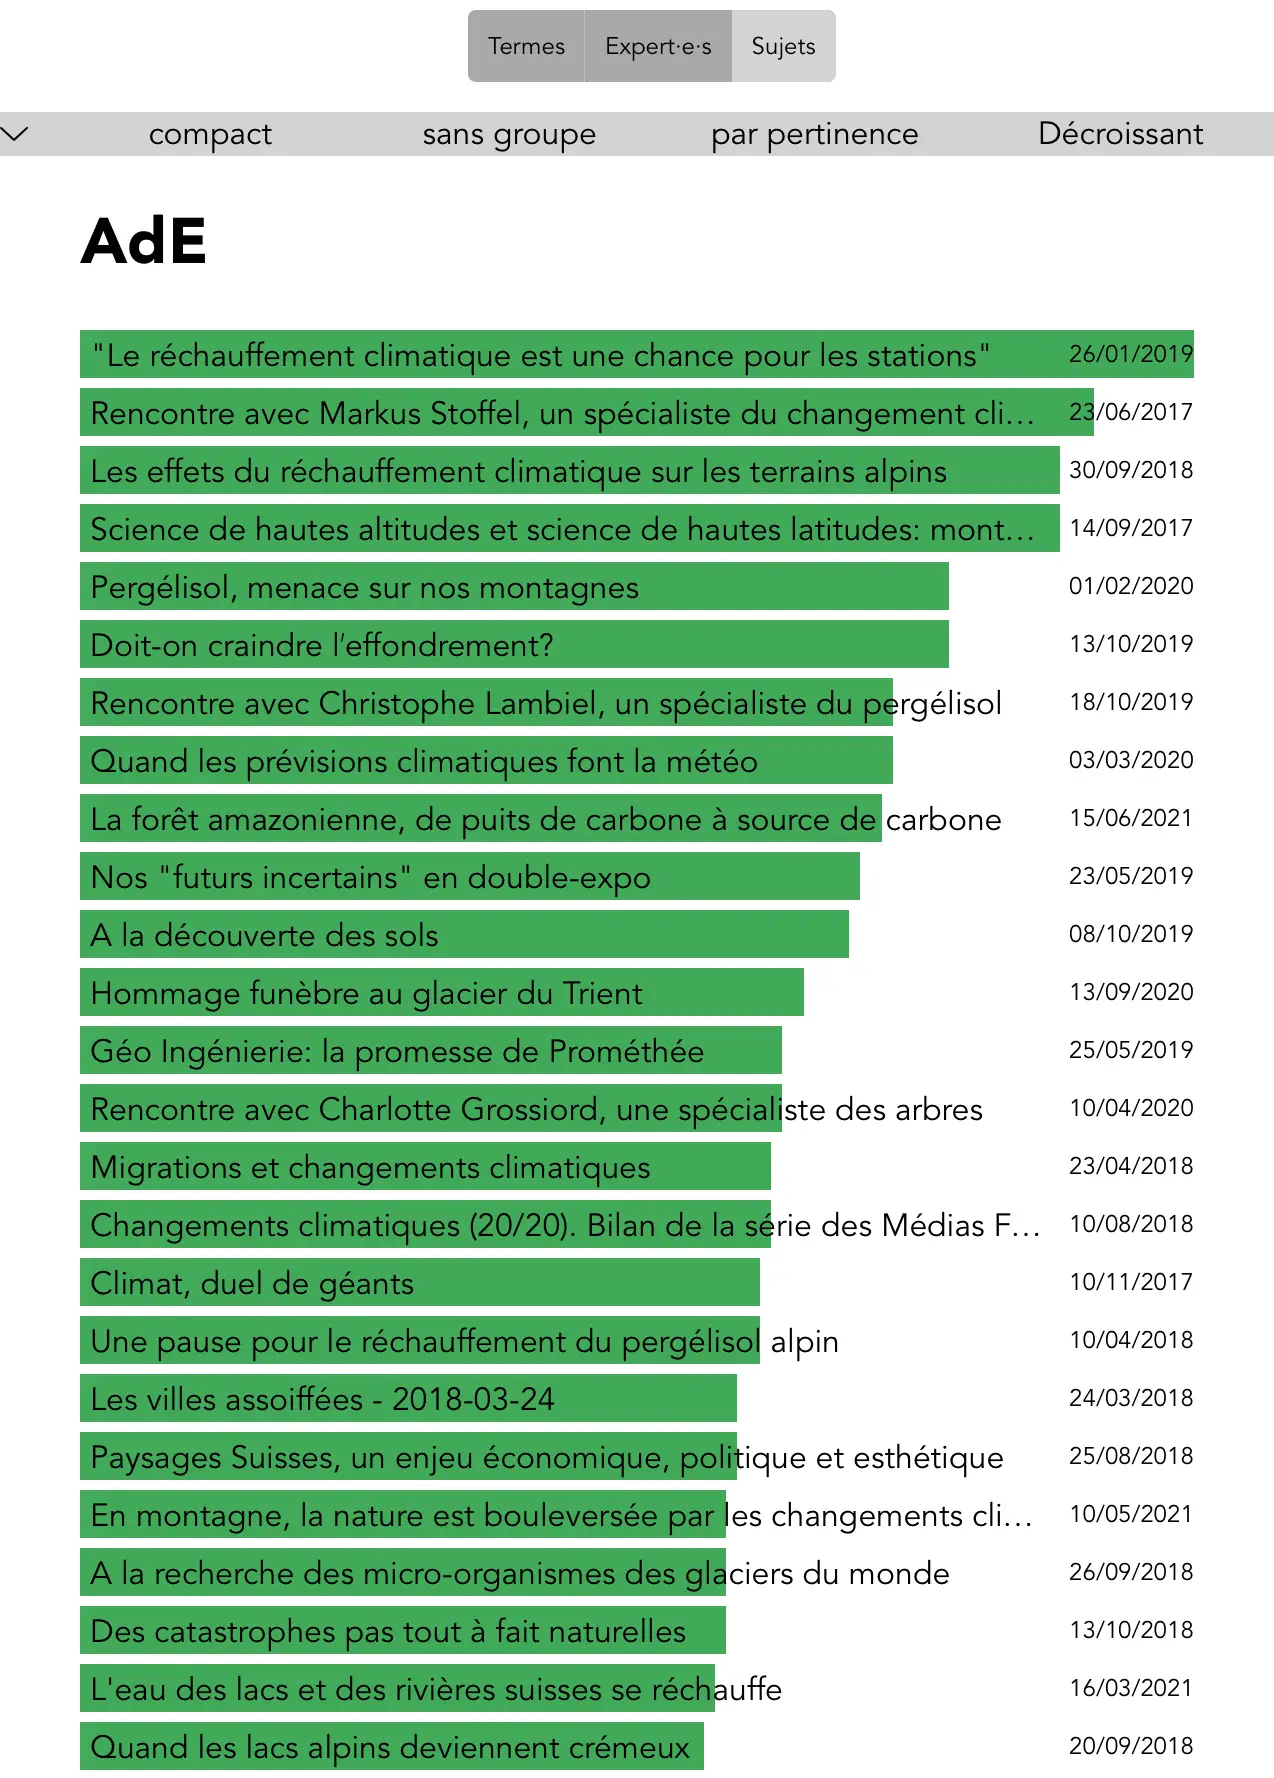
Présente la liste des sujets les plus pertinents pour les critères de recherche (cf. Recherche).
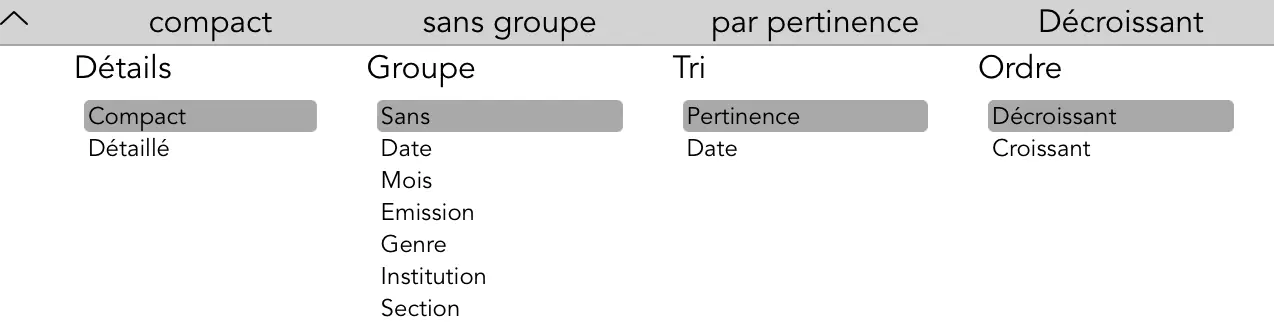
Les sujets peuvent être organisés selon quatre logiques (détails, groupe, tri et ordre).
Options d’organisation des sujets
- Détails
- Compact : seul le titre des émissions est affiché.
- Détaillé : les métadonnées relatives aux sujets sont affichées (émission, expert·e·s, institutions et domaine).
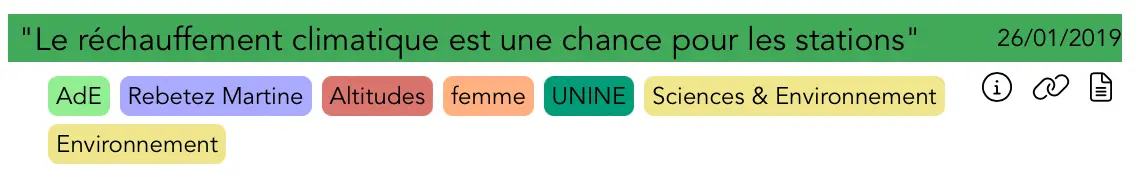
- Groupe
- Sans : les sujets ne sont pas regroupés.
- Date : les sujets sont regroupés par date.
- Mois : les sujets sont regroupés par mois.
- Émission : les sujets sont regroupés par émission.
- Genre : les sujets sont regroupés par genre.
- Institution : les sujets sont regroupés par institution.
- Section : les sujets sont regroupés par section.
- Tri
- Pertinence : les sujets sont triés selon leur proximité avec le réseau sémantique.
- Date : les sujets sont triés par date.
- Ordre
- Décroissant : les sujets sont triés dans l’ordre décroissant selon la méthode de tri choisie (pertinence ou date).
- Croissant : les sujets sont triés dans l’ordre croissant selon la méthode de tri choisie (pertinence ou date).
Dashboard
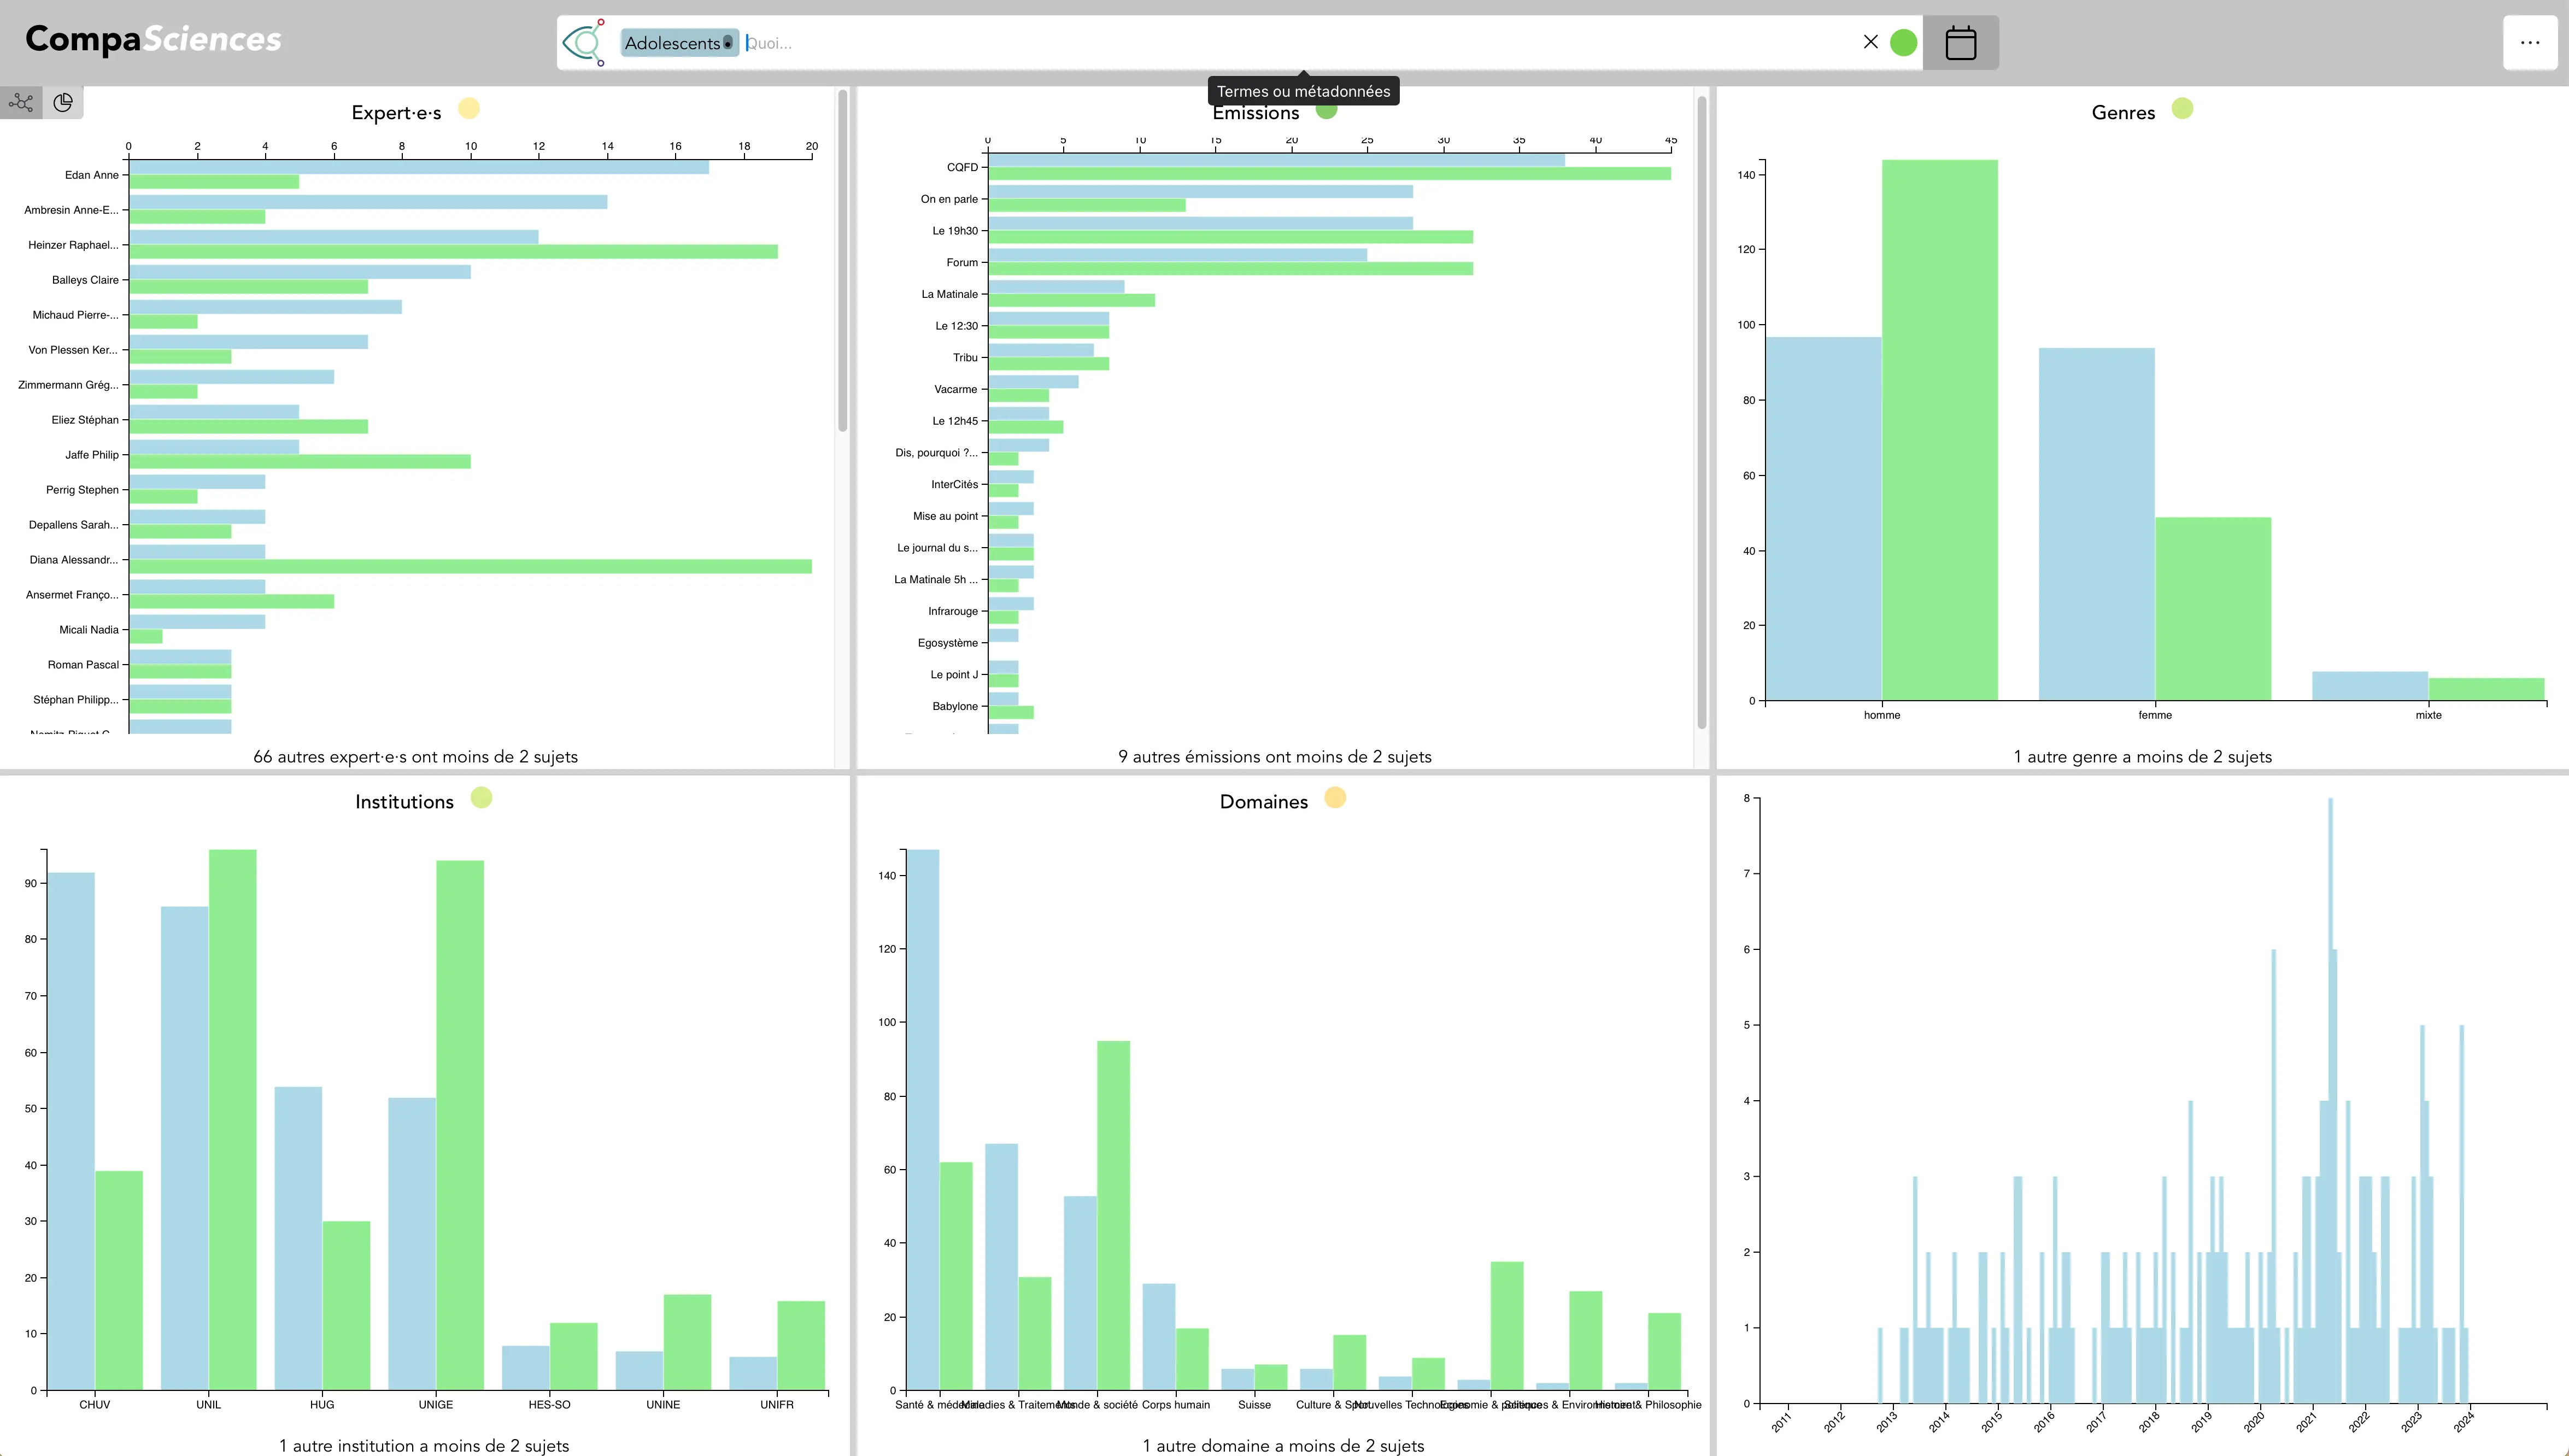
Le Dashboard permet d’explorer le corpus selon ses métadonnées (personnes, émissions, genres, institutions, domaines), en considérant les documents retenus pour une recherche particulière.
Pour chaque métadonnée, le Dashboard présente le nombre de documents observés et le nombre de documents attendus (si la recherche était représentative de l’ensemble du corpus). Par exemple, une institution ou une émission qui rassemble beaucoup de documents dans l’ensemble du corpus peut être très présente dans les résultats, même si elle traite relativement peu du sujet. Cet indicateur permet de faire la différence entre sa présence absolue (nombre de documents observés) et relative (nombre de documents attendus). Cette précision est notamment très pertinente pour le genre, les femmes étant globalement beaucoup moins représentées dans les médias. Elles peuvent ainsi être minoritaires sur un sujet, tout en l’abordant bien plus qu’attendu au regard de leur présence dans l’ensemble du corpus (voir l’exemple ci-dessous sur les adolescents).
Exemple pour une recherche sur les adolescents
Généralisation à d’autres corpus
Le concept de CompaSciences peut être étendu à d’autres corpus de données. À partir des données et des métadonnées fournies, CompaSciences génère automatiquement un environnement d’exploration interactif, intégrant le vocabulaire, les métadonnées et les documents associés. La recherche, avec ses suggestions, devient immédiatement opérationnelle.
Cette approche a été testée sur divers corpus, tels que l’intégralité du journal Le Temps ainsi que les versions francophone et anglophone de Wikipédia. Pour la médiation scientifique, une version complémentaire à celle dédiée aux interventions médiatiques exploite la base de données « Recherche de projets » du Fonds national suisse (FNS).
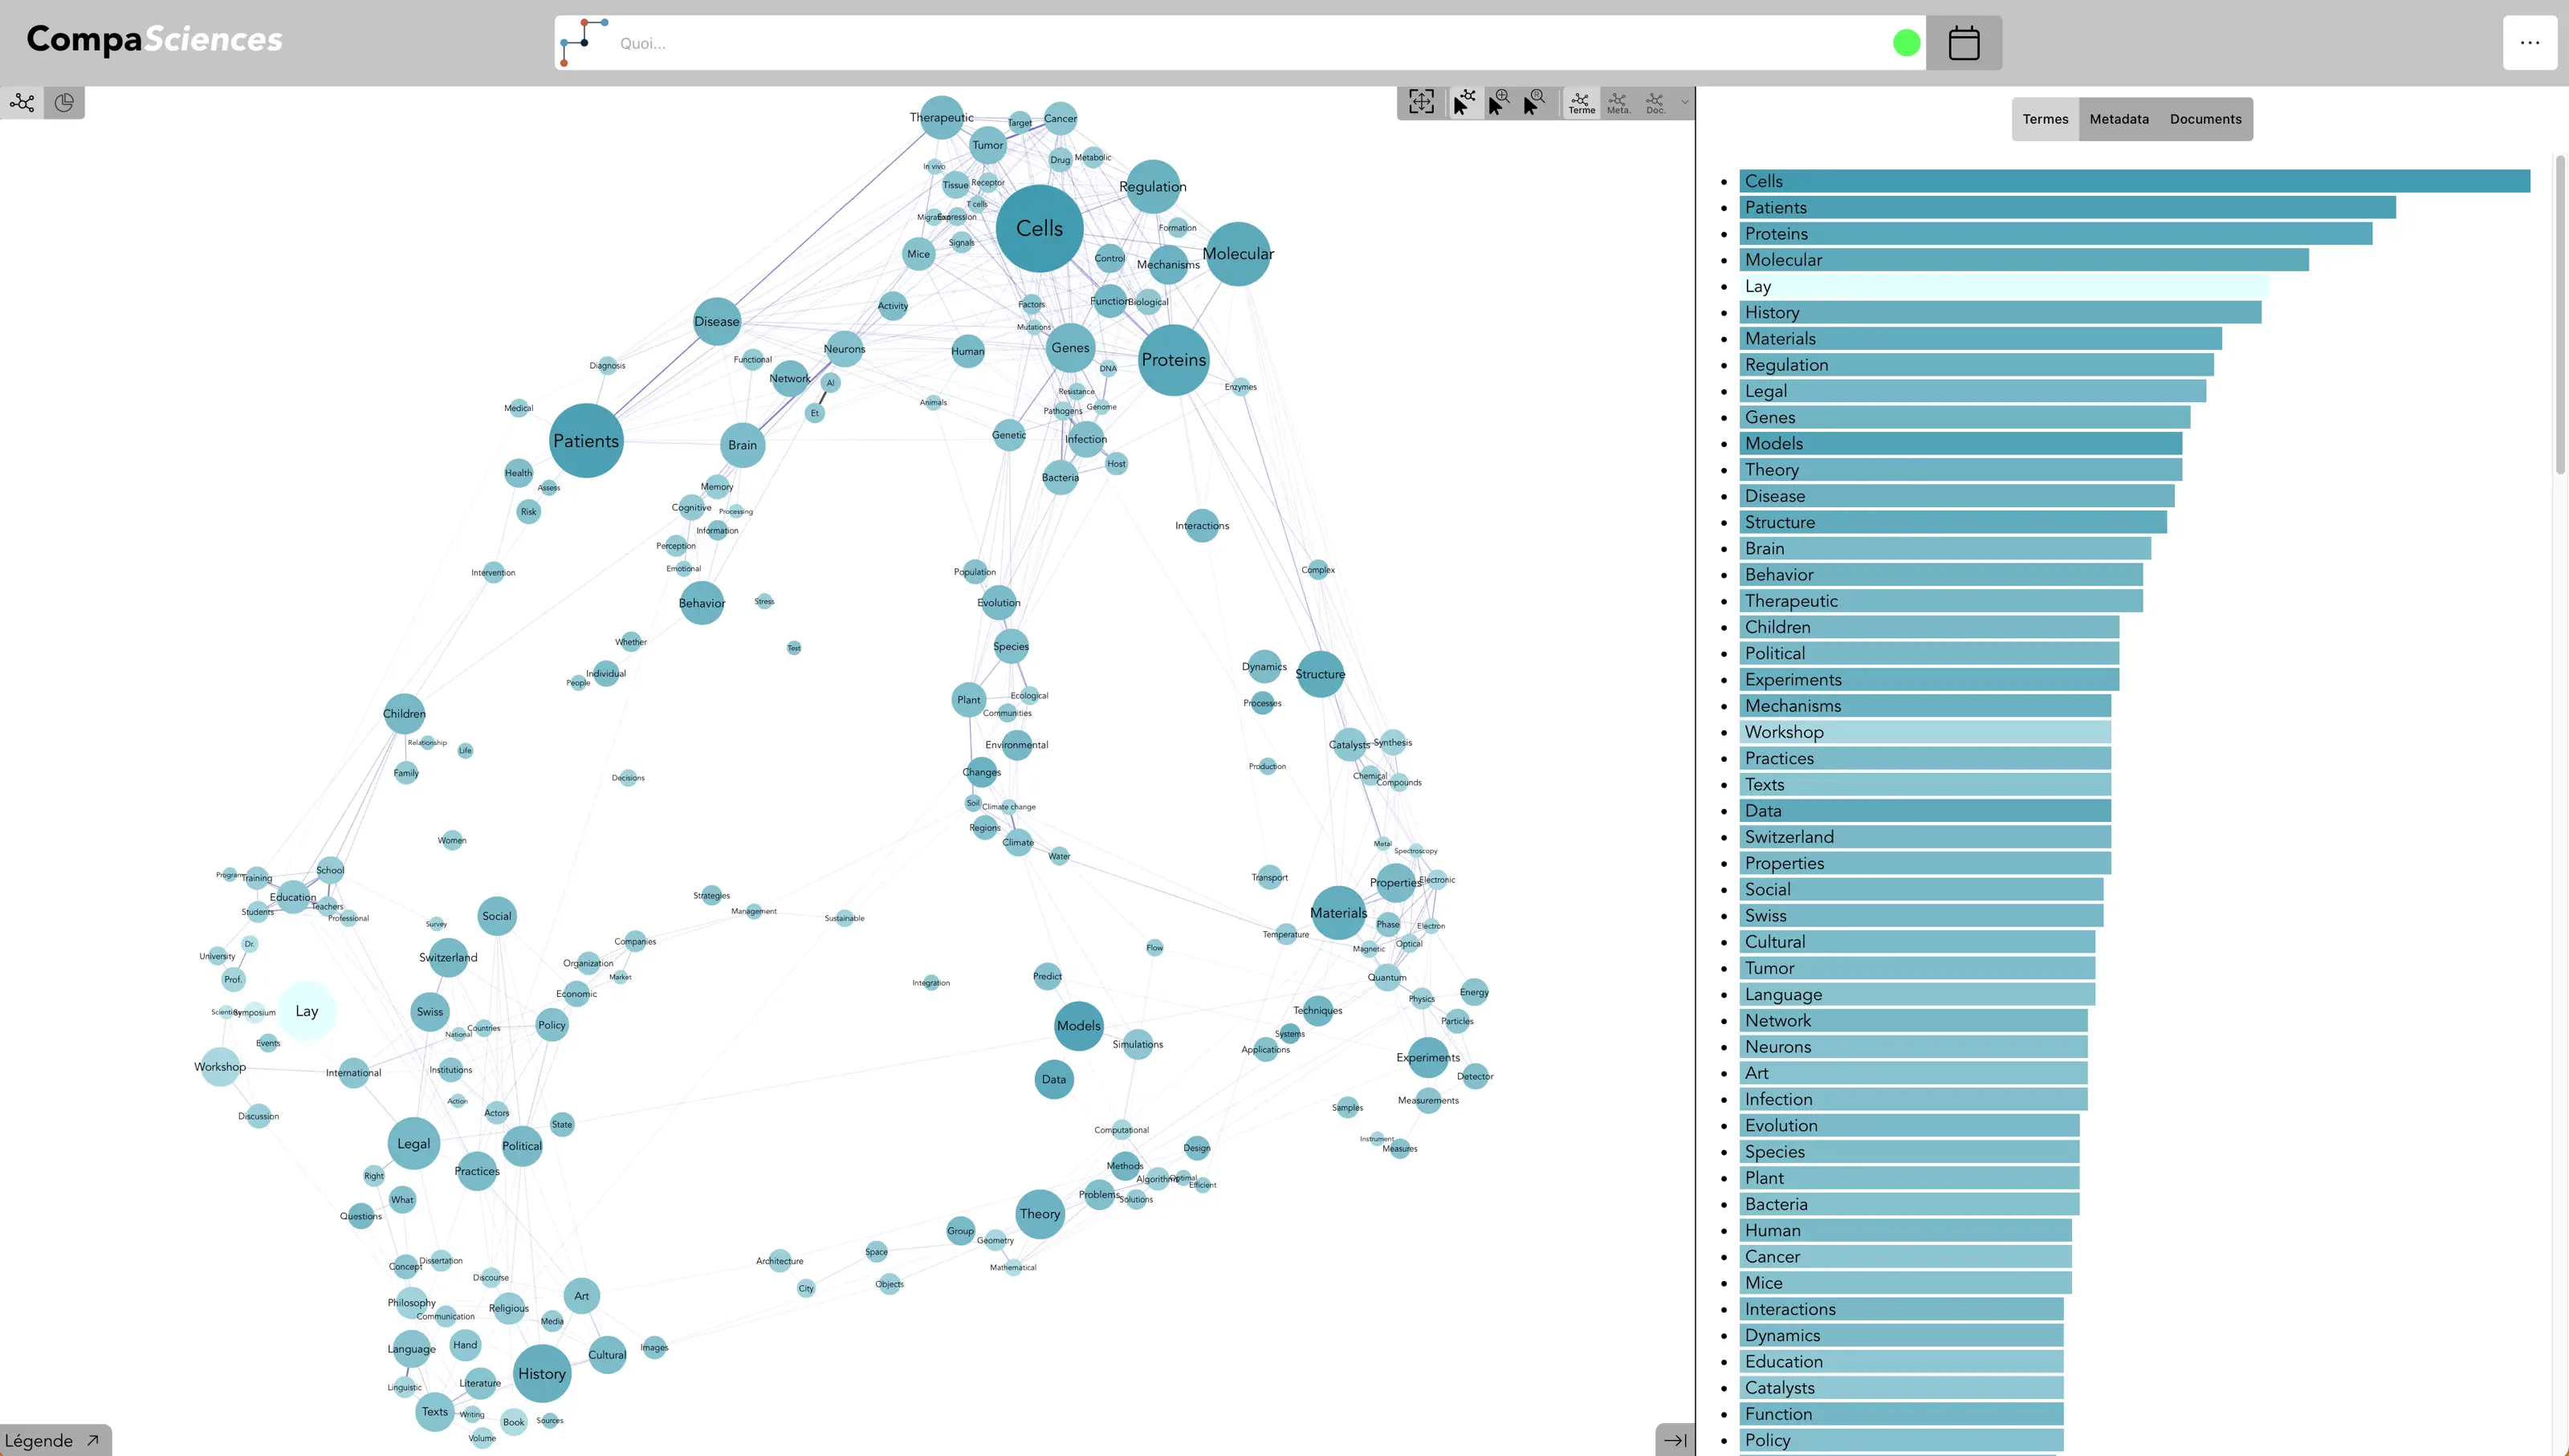
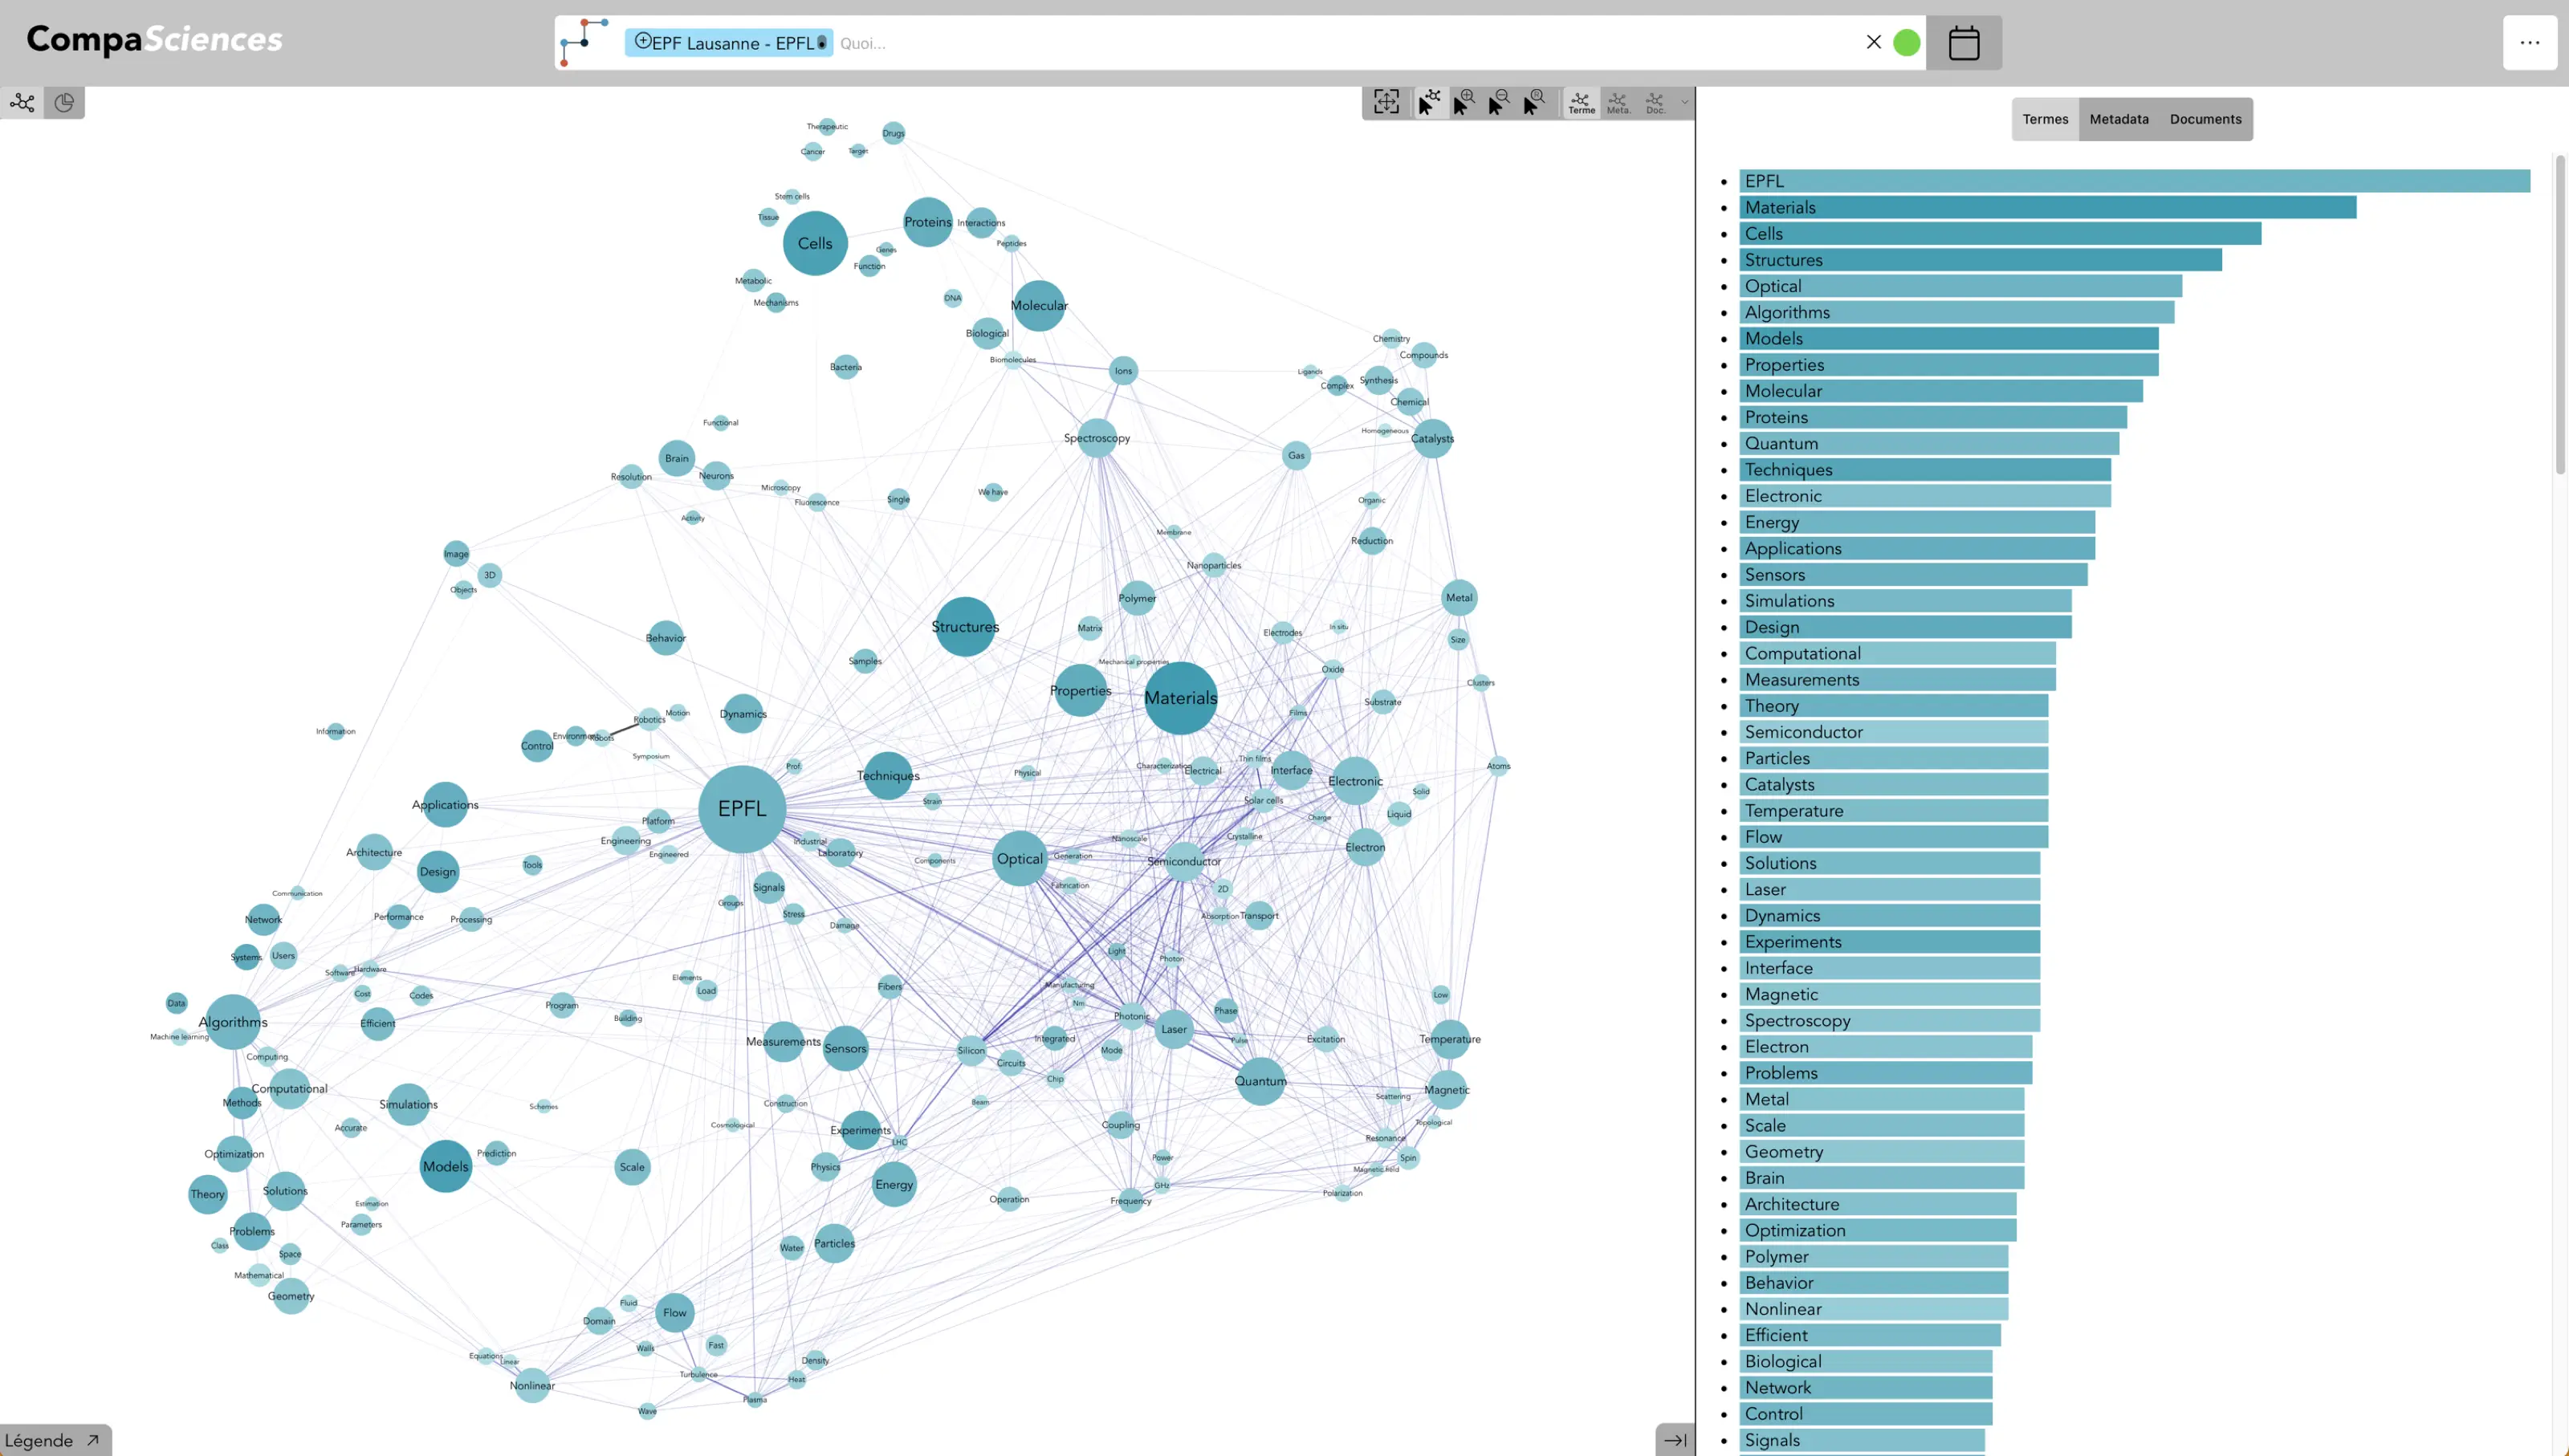
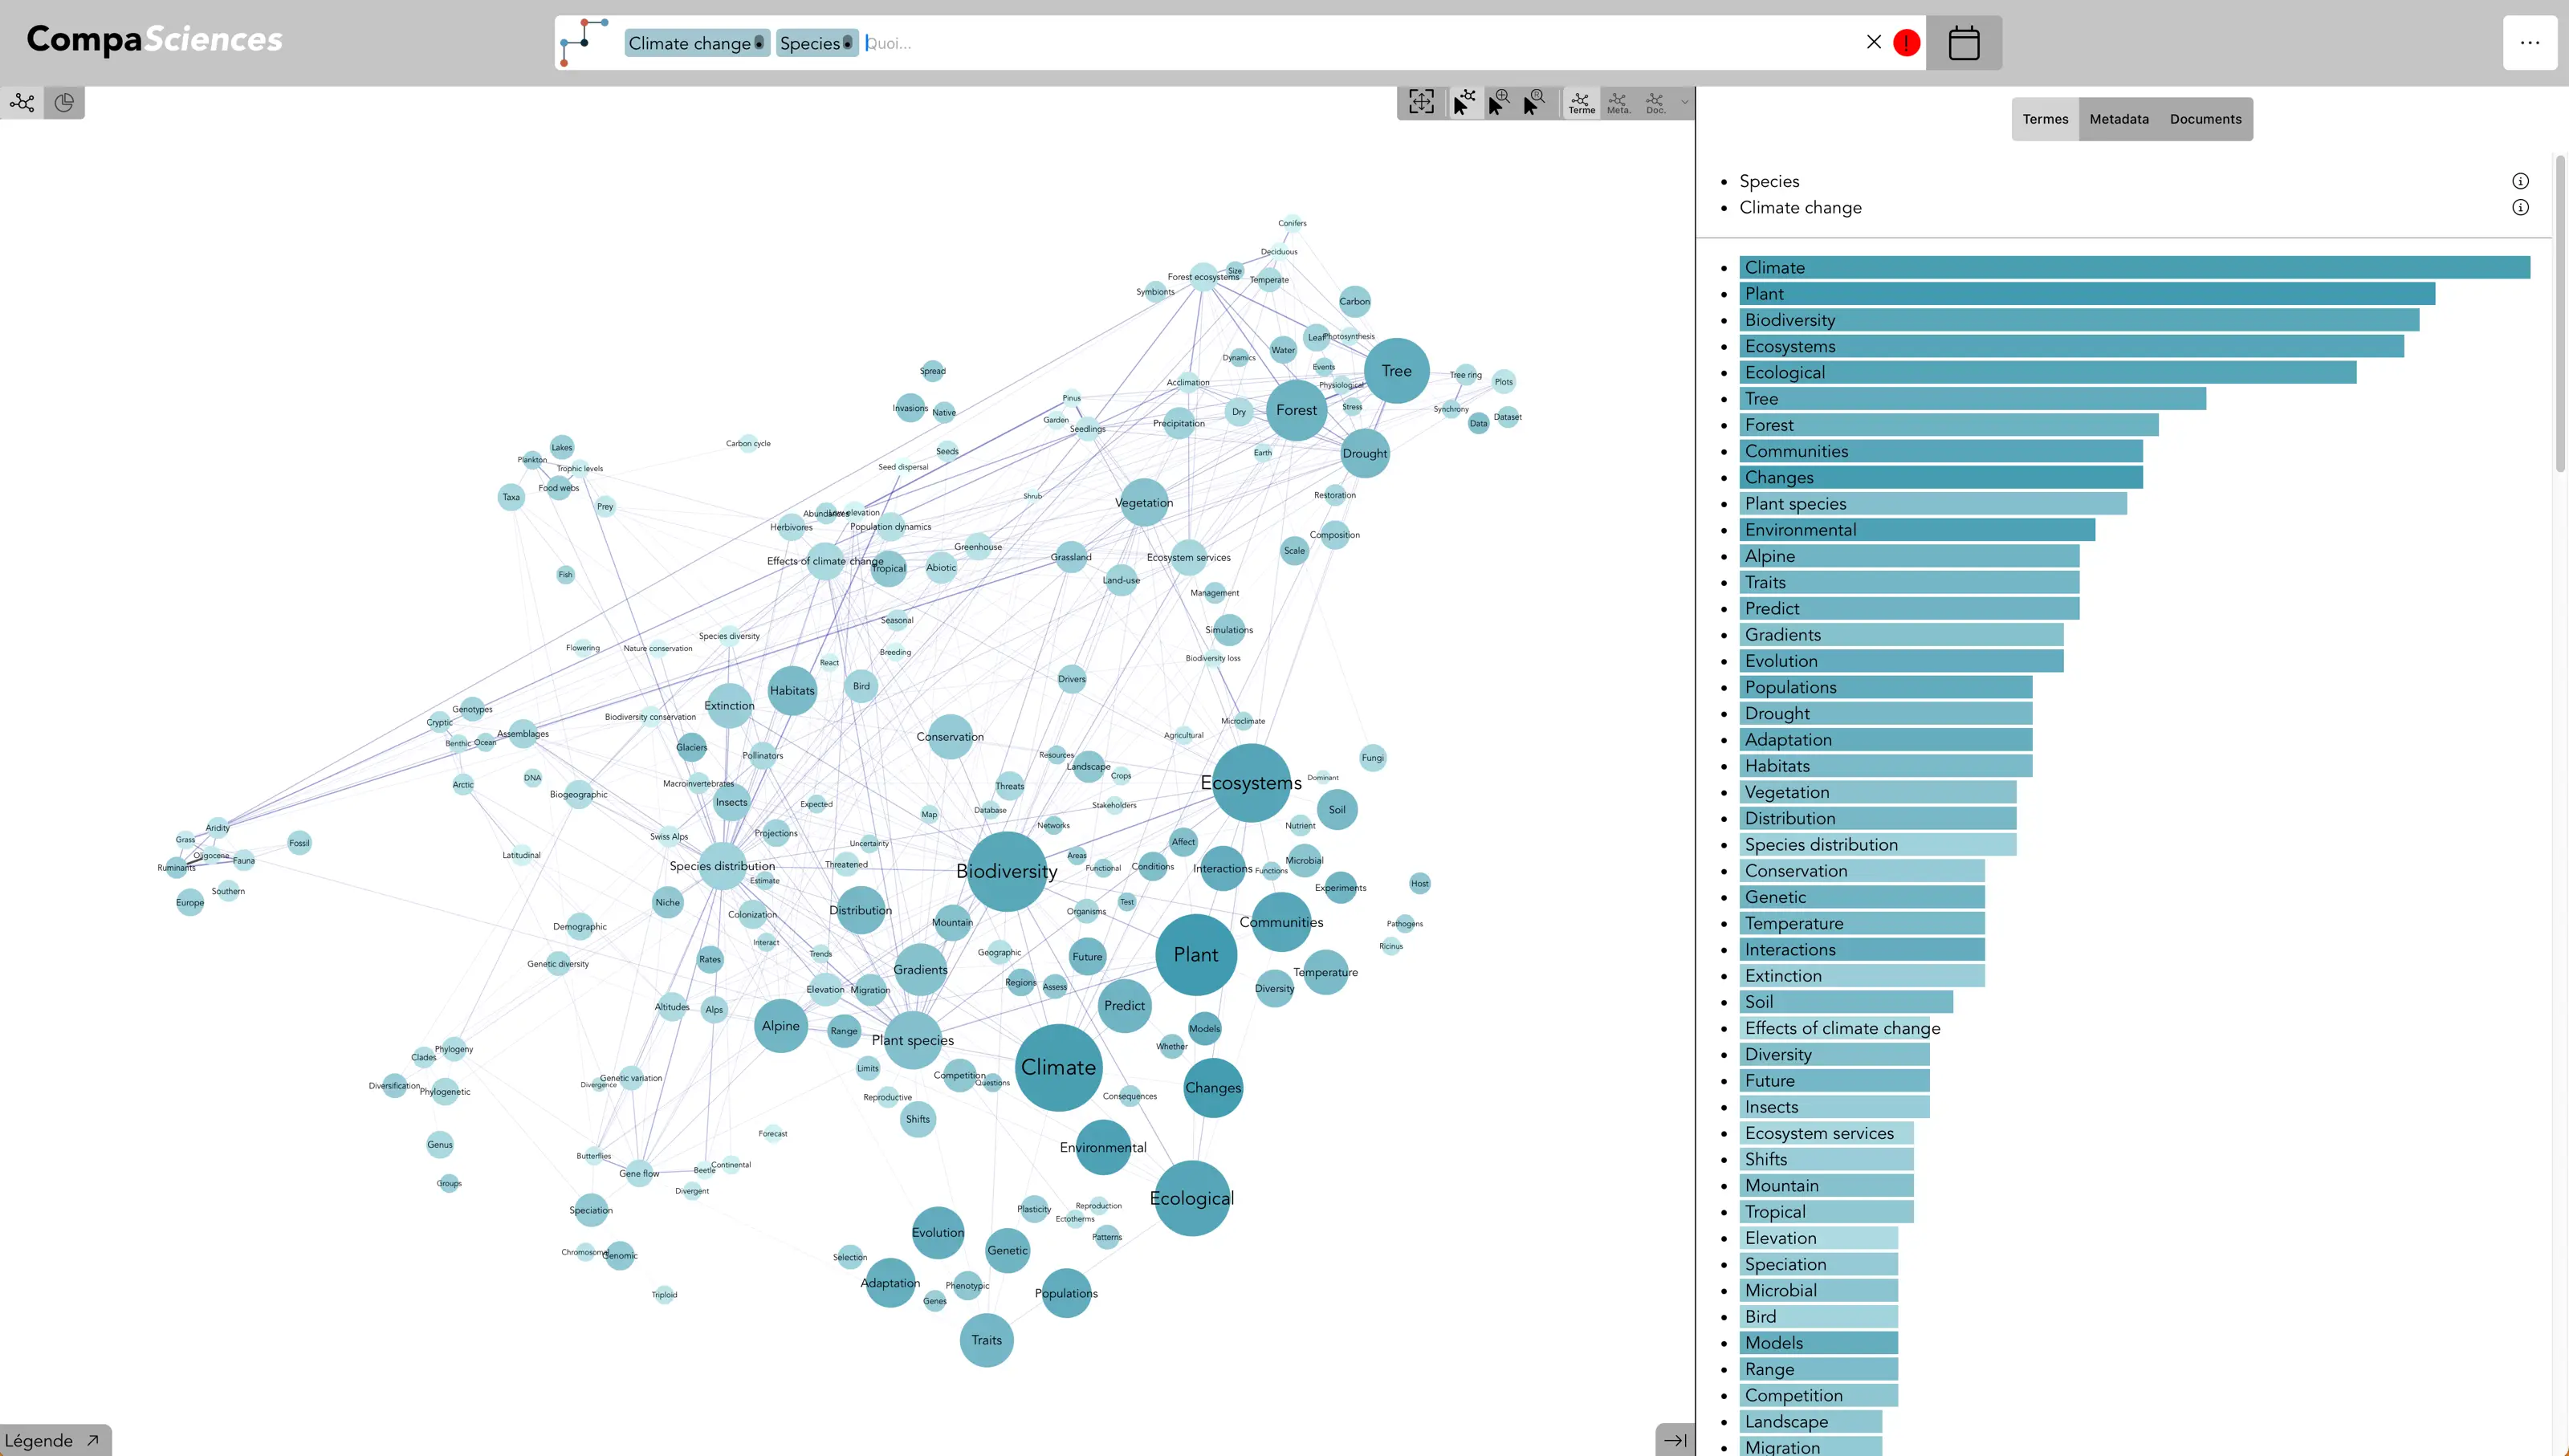
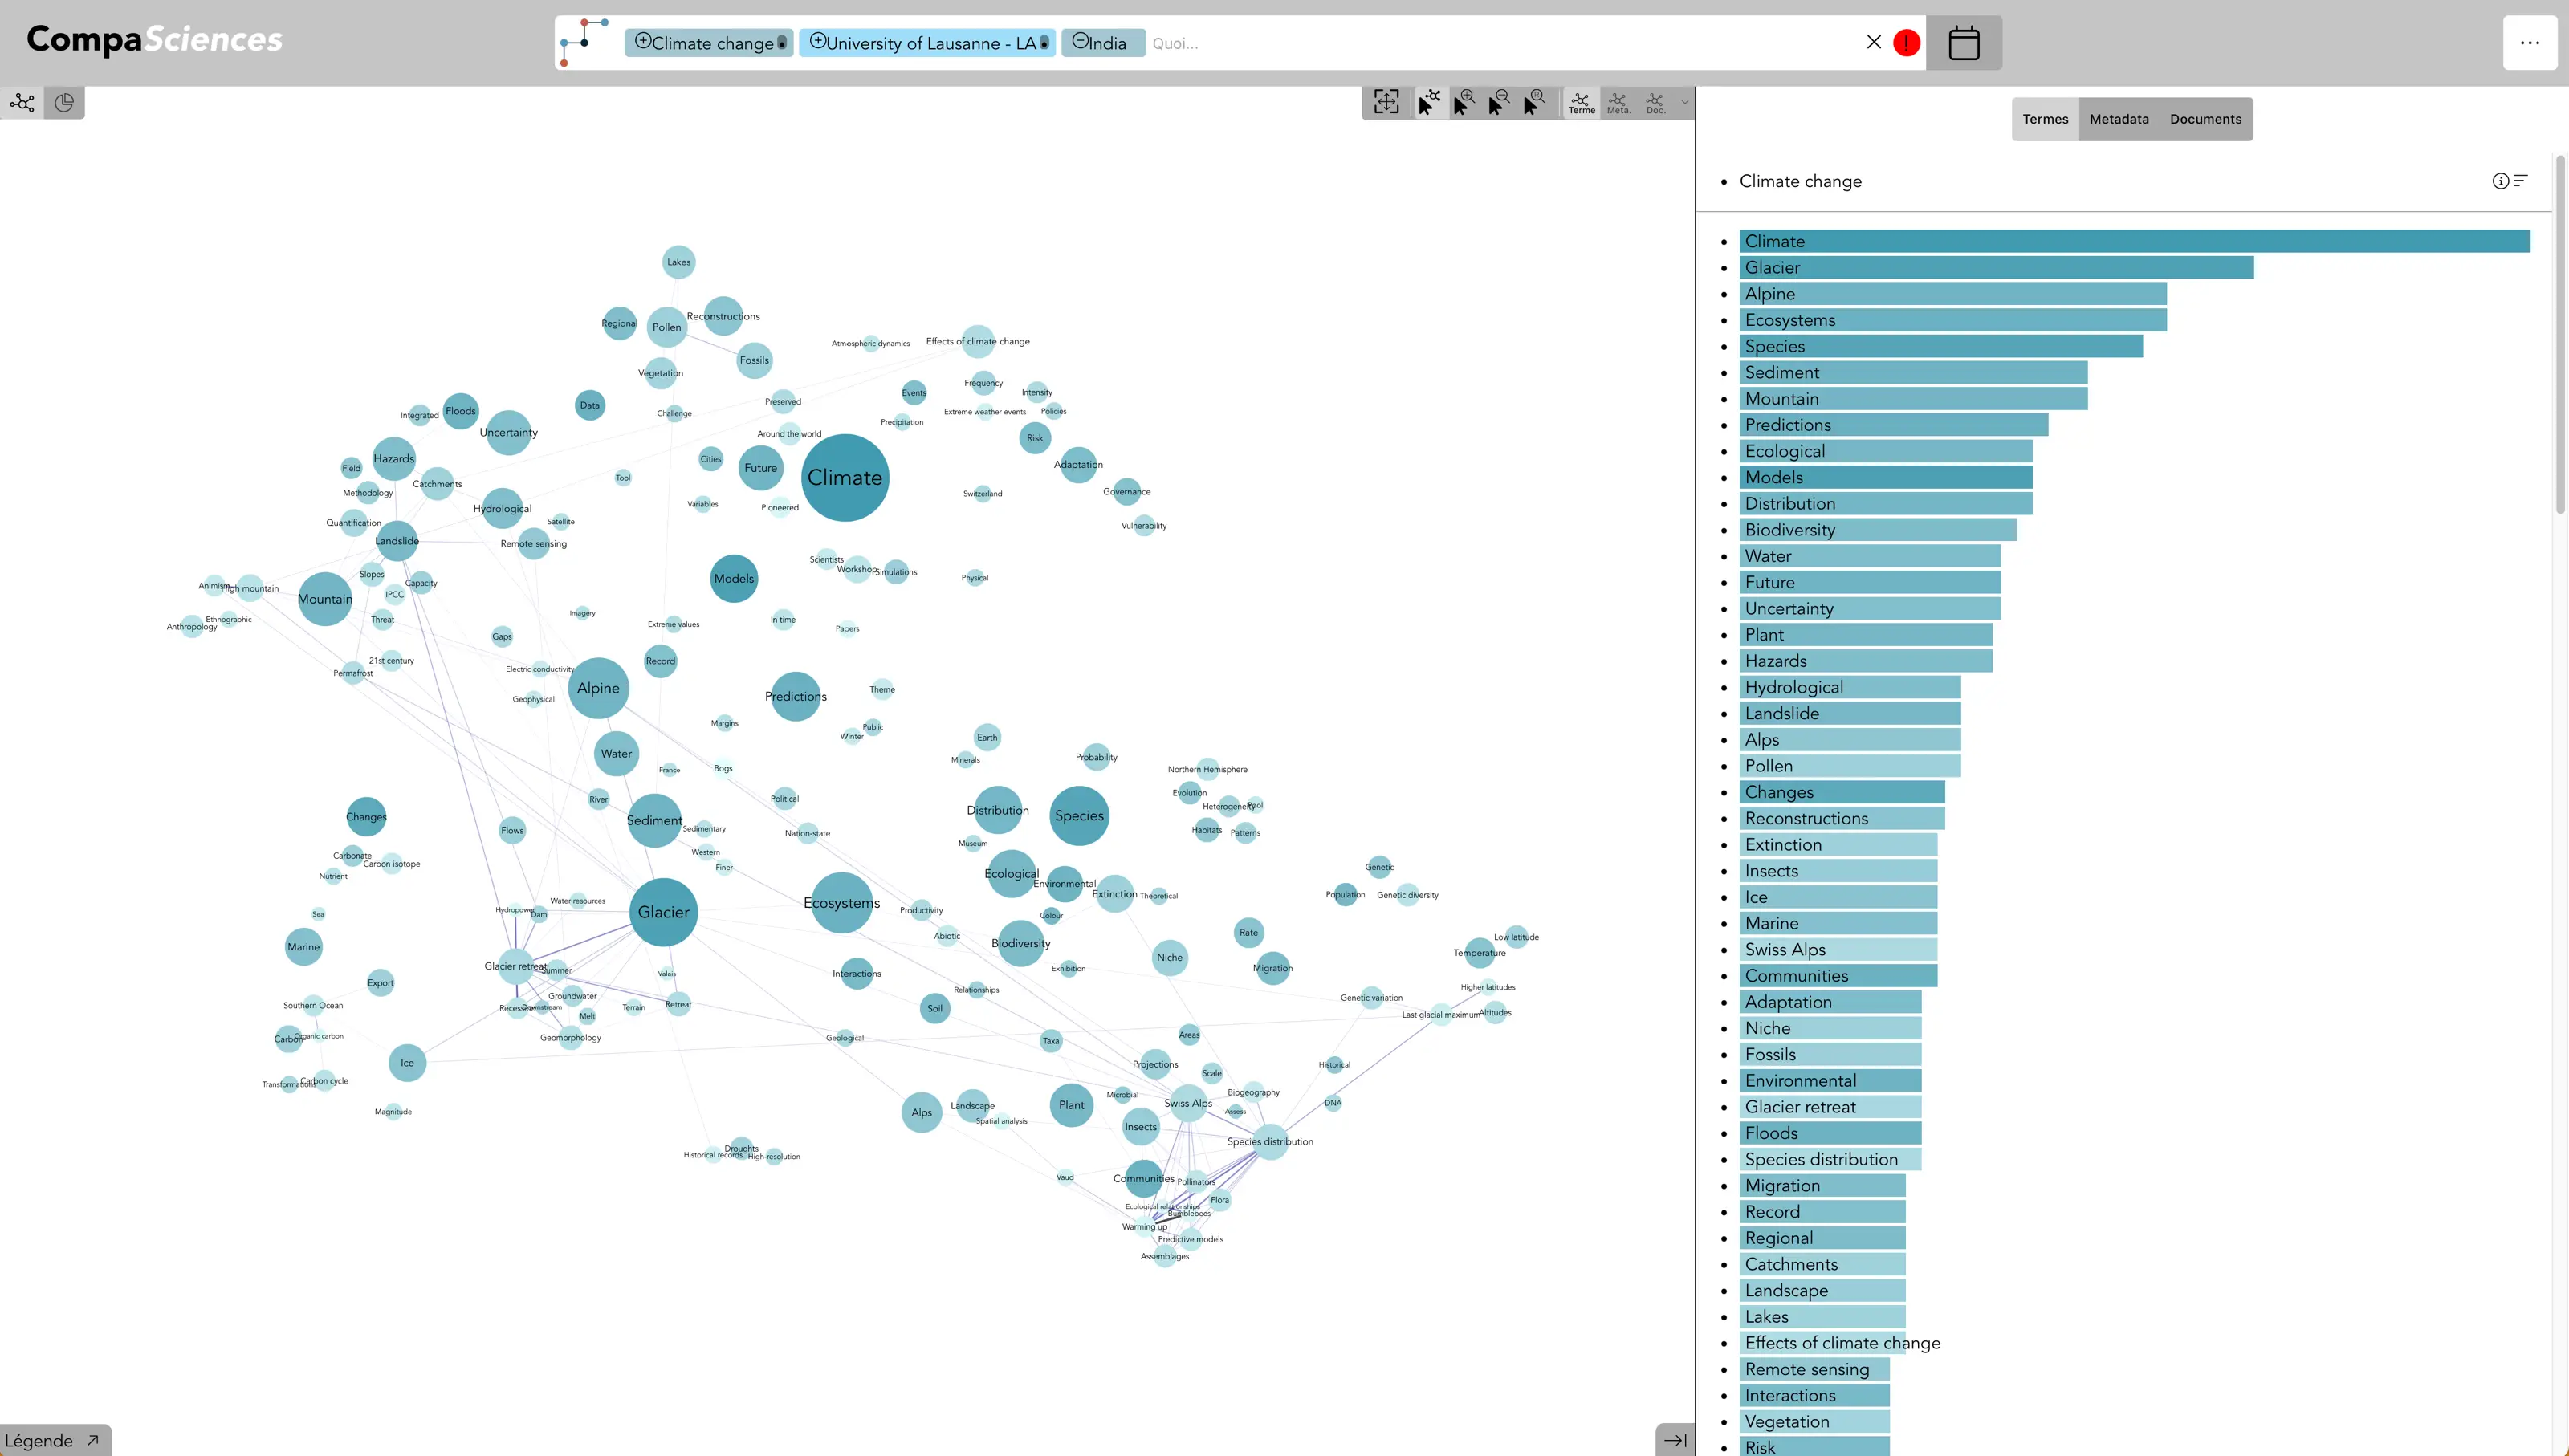
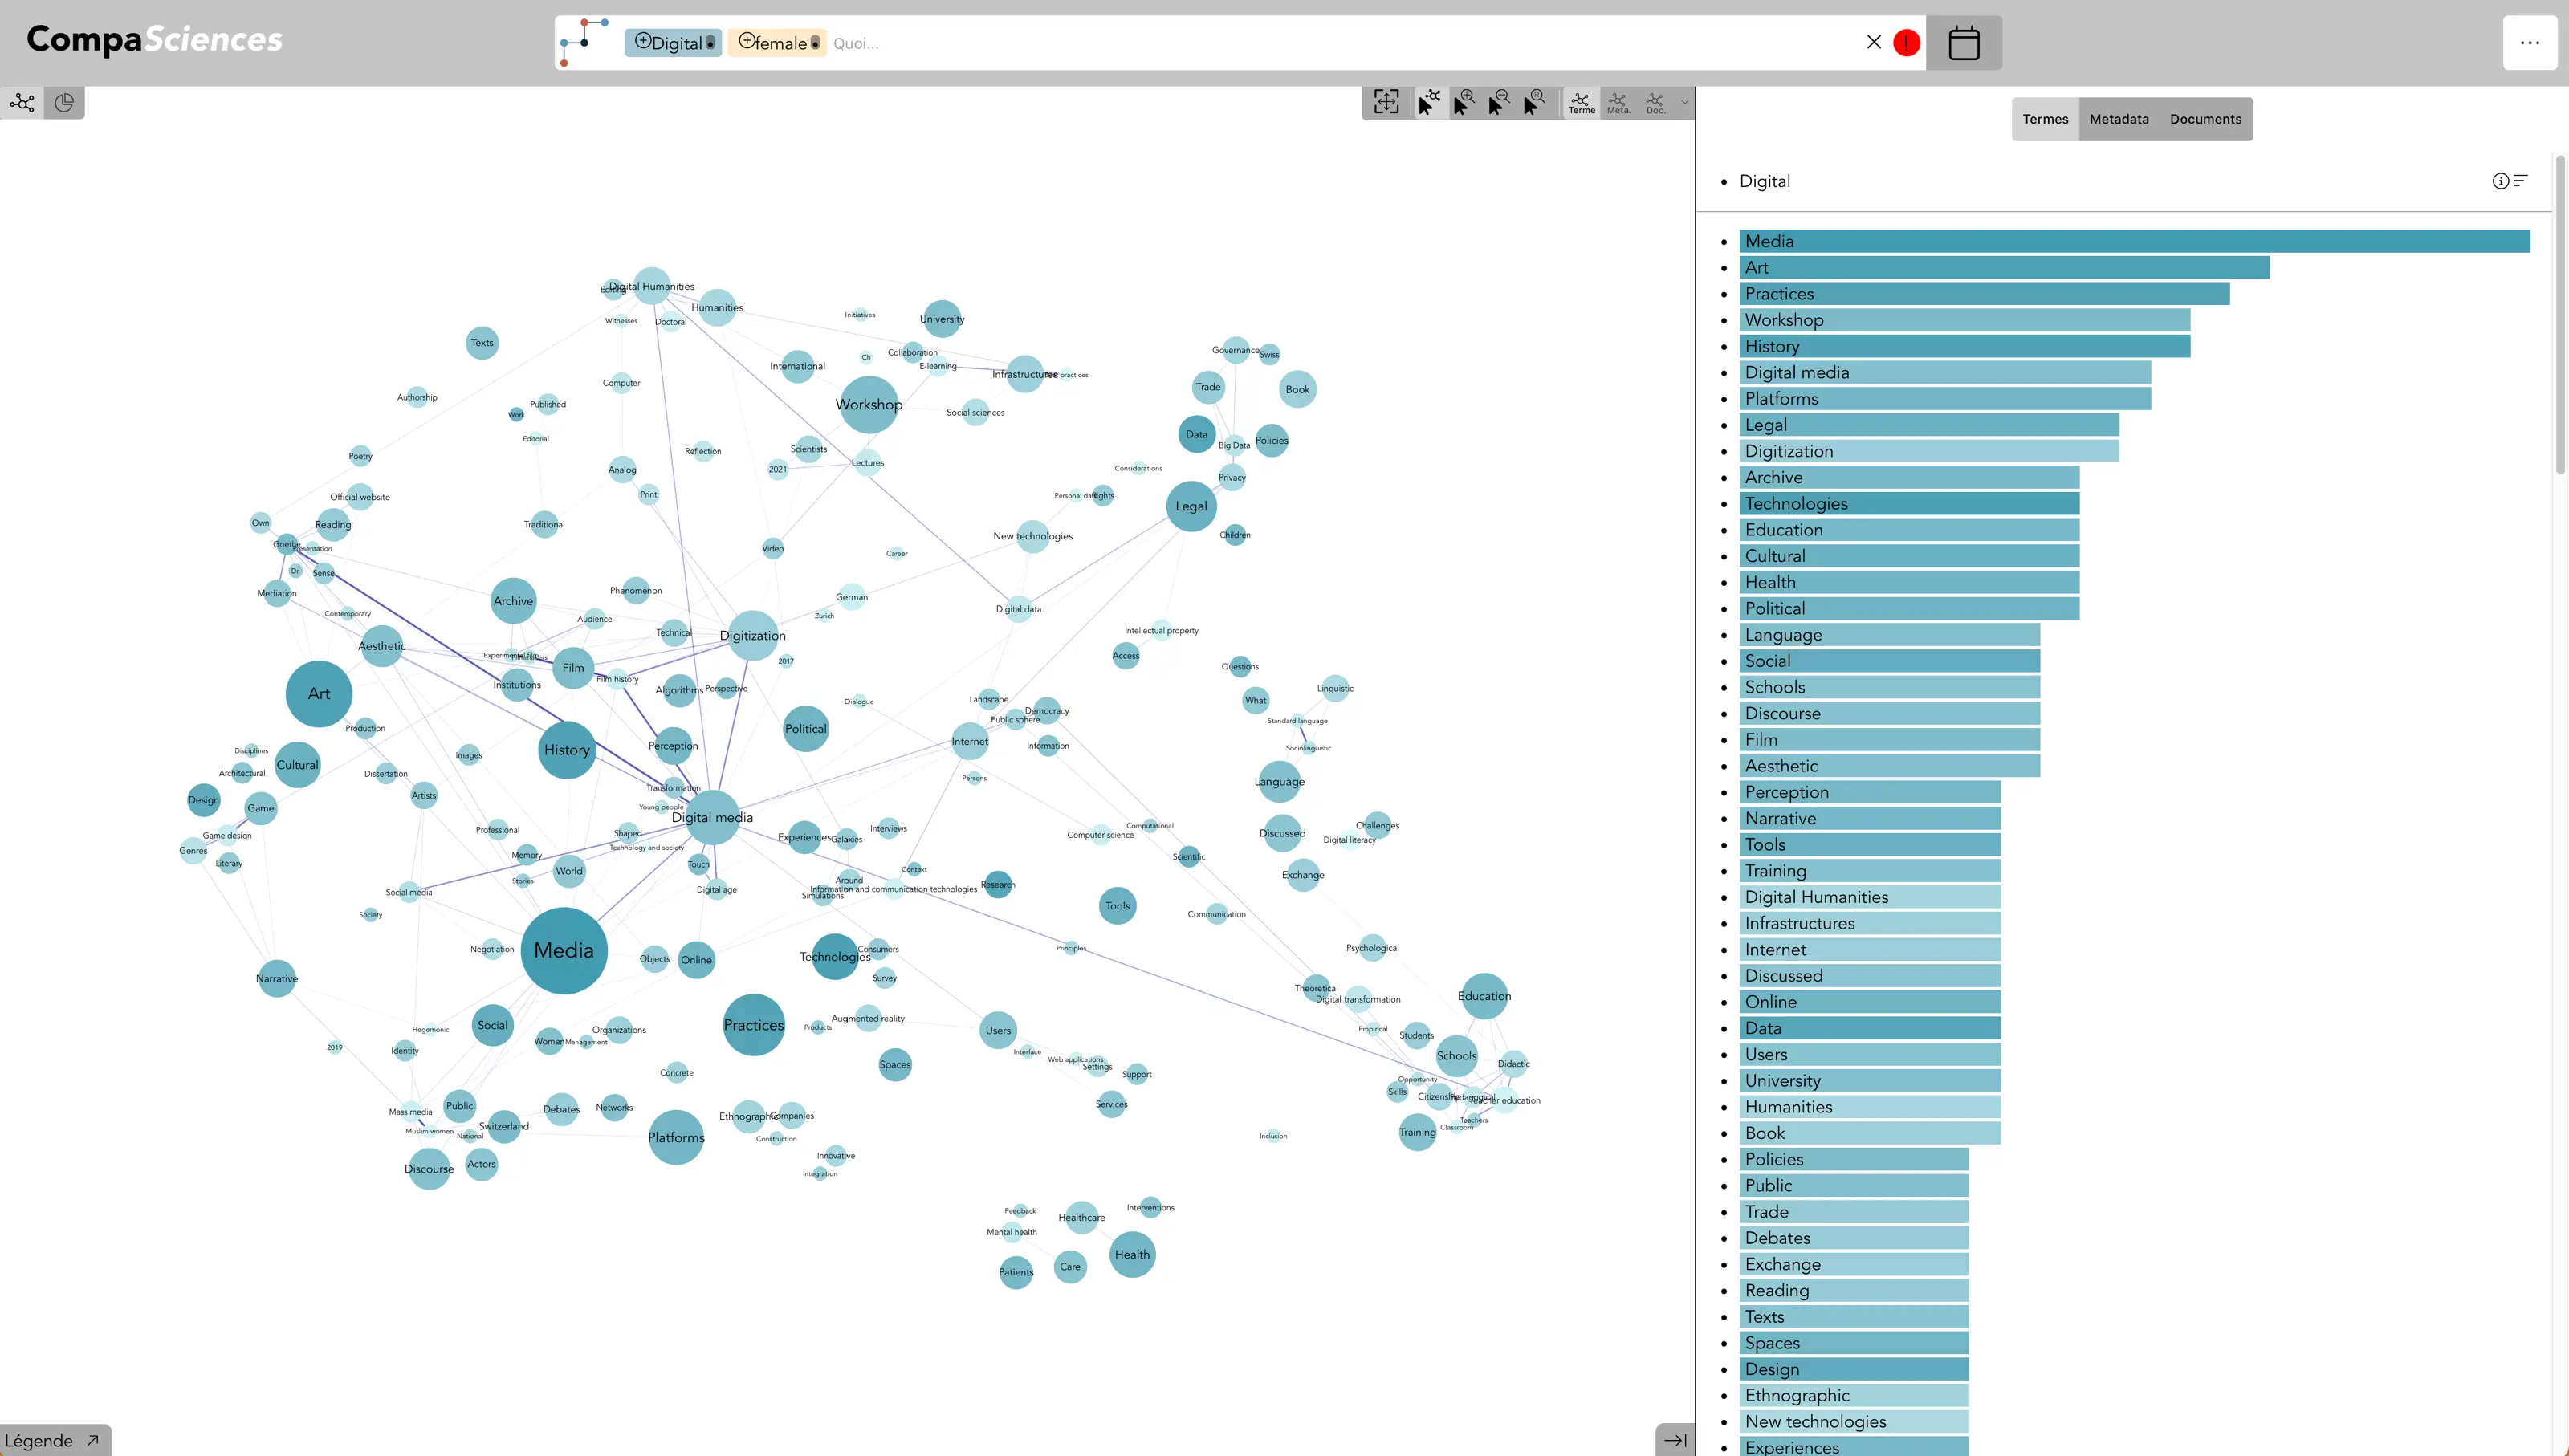
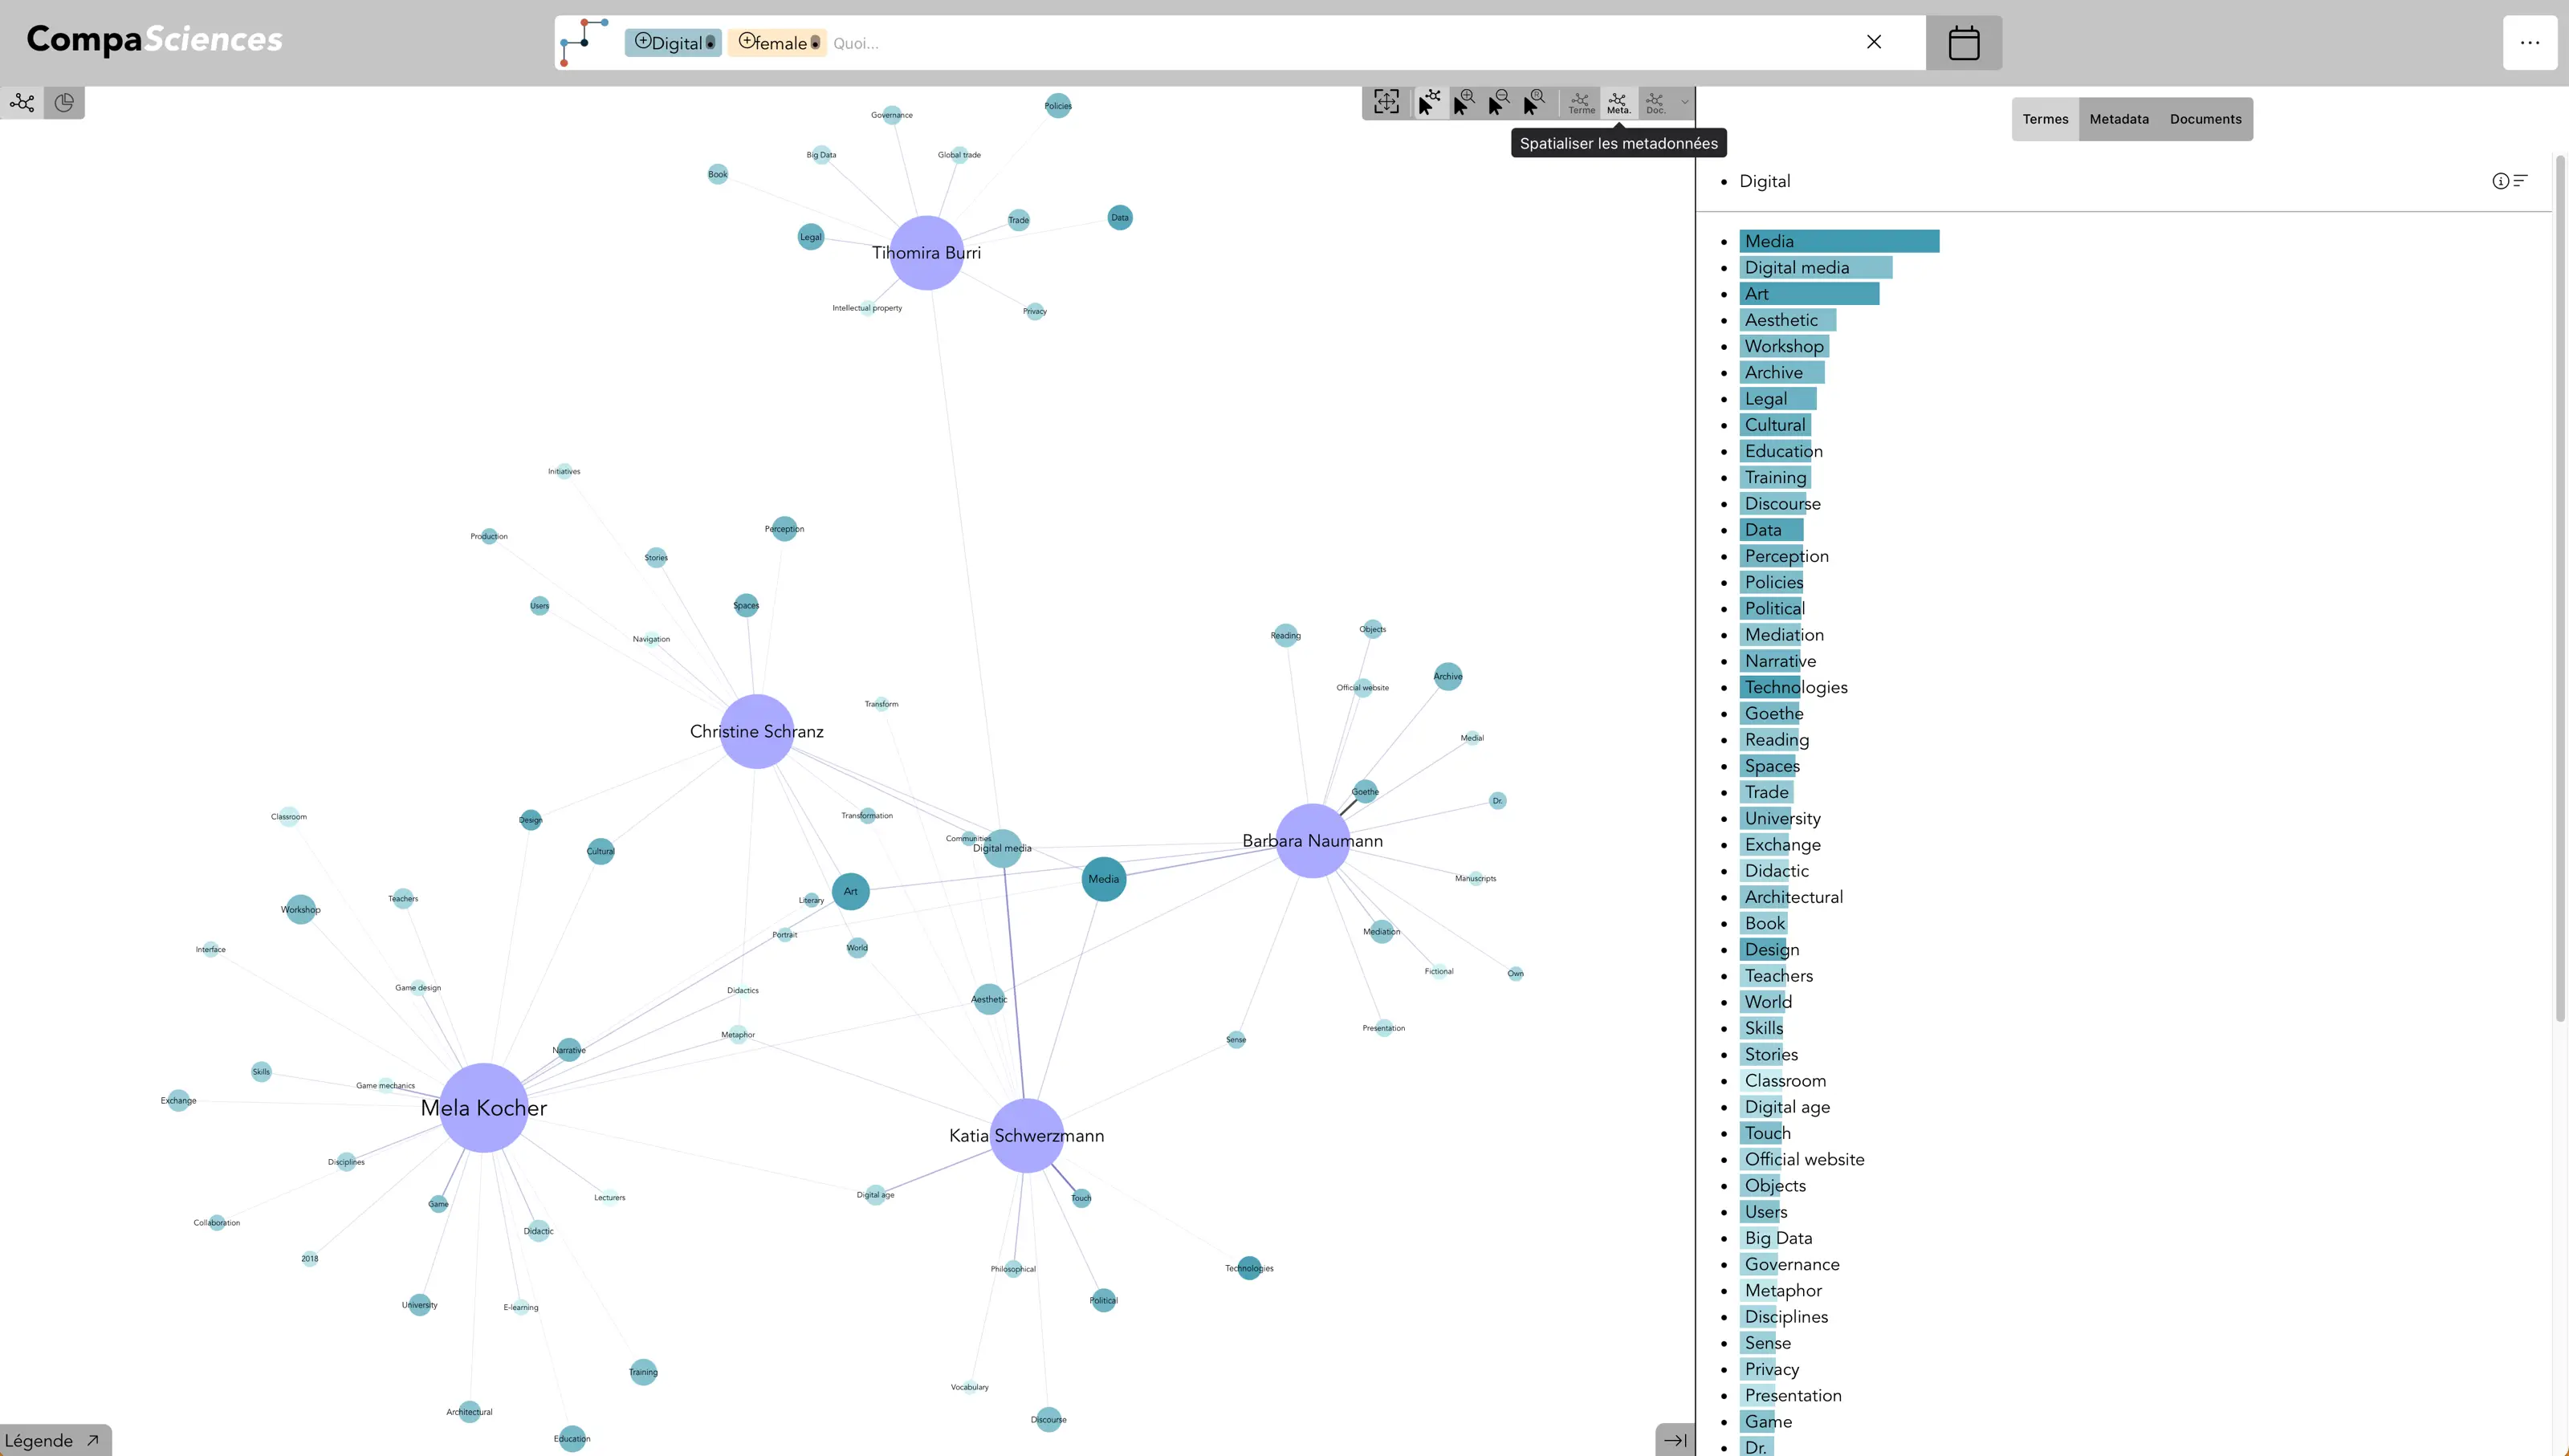
Recherche de projets du FNS
La version FNS de CompaSciences se distingue par l’utilisation d’une base de données multilingue et par la possibilité de tester l’interface dans une autre langue. La base Recherche de projets recense tous les projets financés par le FNS. Elle contient des informations (titre, résumé, description, etc.) disponibles en français, allemand, italien ou anglais. Les données non anglophones ont été traduites automatiquement en anglais.
Cette version de CompaSciences repose donc sur un vocabulaire tout autre, aussi bien sur le plan thématique que linguistique. Elle démontre la capacité de CompaSciences à s’adapter à des corpus de langues et de domaines différents.
Équipe de recherche
CompaSciences est un projet de recherche qui a été financé par l’Initiative for Media Innovation (IMI). Il est à présent soutenu par l’UNIL, afin d’identifier rapidement des expert·e·s de domaines spécialisés. Son équipe rassemble de multiples compétences.
Pr Boris Beaude (UNIL)
Direction du projet
- Conceptualisation
- Analyse et traitement des données
- Interface et communication
Dr Ogier Maitre (UNIL)
Responsable informatique
- Supervision
- Développement de l’interface
Mathieu Pavageau (UNIL)
Développeur sénior
- Développement de la version de production
- Extraction et structuration des données
Personnes ayant contribué à la version expérimentale du projet
Le pilote de ce projet est associé à une recherche qualitative, menée en relation étroite avec des journalistes de la RTS. L’équipe de cette recherche a contribué à la pertinence de CompaSciences. Elle a aussi collaboré avec le projet Avis d’experts (AdE).
Agathe Chevalier (AdE)
Responsable d’Avis d’experts et de la coordination du projet (→ AdE)
Philippe Gonzalez (UNIL)
Direction de la composante qualitative
- Entretiens avec les journalistes
- Pertinence des environnements sémantiques
Ulrich Fischer (MemoWays)
Coordination et collaboration avec Avis d’experts et la RTS (→ MemoWays).
Marine Kneubühler (UNIL)
Responsable des entretiens et de l’analyse qualitative
Matthieu Devaux (UNIL)
Développeur junior
- Développement du prototype